NLWebとは?サイトの商品や記事を自然な言葉で探せる仕組み
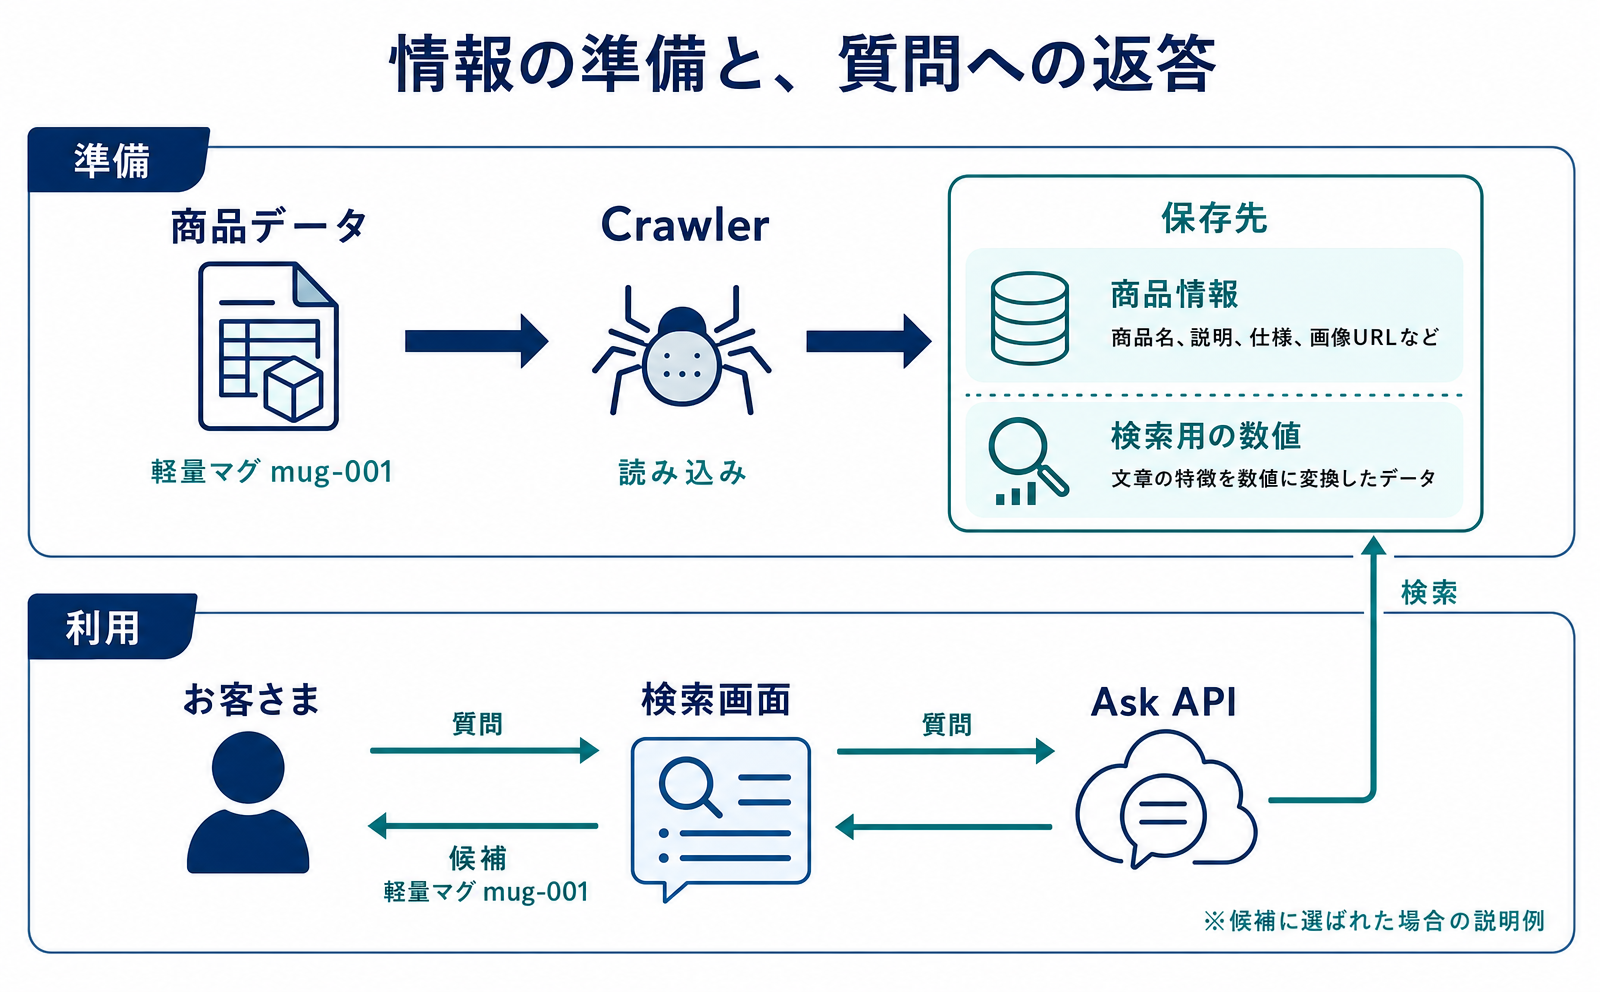
NLWebは、商品名を知らなくても用途や条件を文章で伝えられる検索機能を作るための仕組みです。公式Ask Agentの固定版を基に、商品データの準備から取り込み、質問、候補の返答までを同じ例で解説。注文・決済との違いと、導入前に確認する条件を整理します。
NLWebは、「食洗機で洗える、軽いマグカップ」のように、自然な言葉でサイトの商品や記事を探す検索機能を作るための開発用の仕組みです。商品名やカテゴリを知らない訪問者にも、用途から候補を探す入口を用意できます。商品探しや記事探しを改善したいEC・サイト運営担当者に関係する技術です。[4]
できることの中心は、取り込んだ情報から候補を探すことです。検索結果が返っても、注文や決済が成立したことにはなりません。 管理画面から申し込むだけのサービスではなく、商品情報の準備と検索環境の開発・運用が必要です。
この記事は2026年9月10日時点の公式資料を基にした基礎解説です。具体例はnlweb-ask-agentの固定コミット065581c06d0dad21cdbb7c6623ba99c37517347bにそろえ、ほかのNLWebリポジトリとは区別します。[4][5][6][7]
1. 商品名ではなく用途から探す
食器の通販サイトで、お客さまが「食洗機で洗える、軽いマグカップを探しています」と入力する場面を考えます。キーワードを何度も入れ替える代わりに、欲しいものの条件を一つの文章で伝える使い方です。
NLWebは、保存された情報から質問と意味の近い候補を探し、AIを使って関連度を評価する構成です。商品名の一致だけでは拾いにくい、使う場面や特徴からの検索を作れます。[4]
ただし、店が用意していない重量や食洗機への対応を、確かな商品情報として補えるわけではありません。候補を探しやすくするには、質問に答えられる情報を検索対象へ入れておく必要があります。
以下では「軽量マグ」という説明用の商品を、mug-001として最後まで追います。商品情報、質問、返答の値はすべて説明用で、検索結果や順位の実測ではありません。また、ここで示すのは単発の質問であり、前の質問を踏まえた会話の継続方法ではありません。
2. 情報の準備と検索を分ける
Ask Agentには、情報を集めるCrawler、質問を受け取るAsk API、検索画面のChat Appなどが含まれます。店側は商品情報を整え、実装担当者は収集・保存・検索の環境と、サイトから質問を送る画面を用意します。[4]
| 段階 | 担当するもの | 軽量マグの例 |
|---|---|---|
| 情報を準備 | 店の商品情報担当者 | 商品名、URL、食洗機対応、重量をそろえる |
| 取り込み・保存 | Crawlerと保存先 | mug-001のデータを読み、検索に使える状態にする |
| 質問を送信 | サイトの検索画面 | お客さまの文章をAsk APIへ送る |
| 候補を返答 | Ask API | 検索・順位付けした候補を画面側へ返す |
検索では、文章の特徴を数値に変換するembeddingという処理を使います。この数値を保存しておくことで、質問と意味の近い情報を探せます。既定の構成では、検索用の保存先がAzure AI Search、文書全体の保存先がAzure Cosmos DBです。[4]
商品情報を取り込む流れと、質問に答える流れは別です。商品ページを更新しただけで検索用の保存先も最新になるとは限らないため、運営では両方を管理します。
3. 商品データを取り込む
サイトマップと商品詳細は別
READMEのドメイン収集例では、サイトのルートにsitemap.xmlが必要です。実装担当者がPOST /crawler/api/sitesへ次の本文を送り、収集対象のサイトを指定します。site_urlは対象サイトのURLで、商品そのものを送る項目ではありません。[4]
{
  "site_url": "https://example.com"
}
通常のサイトマップは、主にURLの一覧を伝えるものです。そこにマグカップの重量や食洗機対応などの製品詳細が入っているわけではなく、サイトの登録と商品データの読み込みは分けて考えます。
固定版のCrawlerにあるextract_objects_from_schema_fileは、取得したファイルの内容からJSONオブジェクト・配列、JSONL、TSV、RSSを解析します。TSVではURLとJSONをタブで区切る処理、RSSでは記事データへ変換する処理があり、どの形式も無条件に同じ扱いではありません。[5]
READMEの「schema.org sitemaps」という表現だけを見て、通常のサイトマップや商品ページ内の構造化データが、そのまますべて取り込まれると考えないことが重要です。実装担当者とは「入口となるサイトマップ」と「商品詳細を渡すデータファイル」を別々に確認します。
軽量マグの情報をJSONにする
ここでは、Crawlerの読み込み対象となるJSONファイルに、次の商品オブジェクトを用意する例にします。APIへの質問本文ではなく、店側が検索用に渡す元データです。[5]
{
  "@context": "https://schema.org",
  "@type": "Product",
  "@id": "https://example.com/products/mug-001",
  "url": "https://example.com/products/mug-001",
  "name": "軽量マグ",
  "description": "食洗機対応。重さ180gの軽量マグカップです。"
}
@typeは商品の種類、@idはこの商品を識別する値、urlは商品ページの場所です。nameとdescriptionに、表示する名称と検索に役立つ特徴を入れています。この例では識別用URLと商品ページURLを同じにしています。
読み込み処理では、このようなJSONから対象オブジェクトを取り出し、@idを使って識別します。Productは確認した除外対象に含まれず、この例はJSONオブジェクトとして読み取る分岐をたどれます。[5]
続く処理では、識別子、対象サイト、商品オブジェクトを組にして保存処理へ渡し、文書全体をCosmos DBへ追加・更新します。検索用の数値をAzure AI Searchへ保存する構成と合わせて、後の質問で探せる情報を準備します。[4][5]
ここまでで追えるのは、読み込み対象に届いた商品データが、識別子付きの保存処理へ渡る関係です。サイトマップからこのJSONファイルを発見・登録する設定までを含む、完成した導入手順ではありません。
運営担当者が確認したいのは「収集を開始できたか」だけでなく、「mug-001の名称と特徴が保存され、検索対象になったか」です。READMEには進捗の確認先として/crawlerが案内されています。[4]
4. 質問を送り、候補を受け取る
画面からAsk APIへ送る
商品情報を取り込んだ後、サイトの検索画面がPOST /askへ質問を送ります。READMEのソース起動例では、ローカルの送信先はhttp://localhost:8080/askです。[4]
次の例は、READMEの質問形式に、同じ固定版の型定義にある返答形式の指定を加えたものです。返答の候補一覧を説明するため、conv_searchを明示しています。[4][7]
{
  "query": {
    "text": "食洗機で洗える、軽いマグカップを探しています"
  },
  "prefer": {
    "streaming": false,
    "response_format": "conv_search"
  }
}
query.textがお客さまの質問、prefer.streaming: falseが返答を少しずつ受け取らない指定です。prefer.response_formatは返答の形式で、型定義上の既定値はchatgpt_appのため、ここでは候補一覧を扱うconv_searchへ変えています。[7]
同じ型定義では、質問本文の必須部分はqueryと、その中の文字列textです。検索件数などには既定値があり、この記事の質問例では省略しています。サイトの絞り込みも省略した例なので、自社用の環境に対象商品だけを取り込んでいる想定です。[7]
返答のどこを見るか
Ask APIは保存済みの情報を検索し、候補を順位付けします。mug-001が候補に選ばれた場合を、同じ固定版のAnswerResponseConvSearch、ResultObjectと、RankedResult.to_dictの変換処理に沿って示します。[6][7]
次は返答のresults部分から、商品を追うための項目だけを抜き出した説明用JSONです。完全なレスポンスには必須の_metaなどもあり、この抜粋をそのまま完全な応答として扱うものではありません。
{
  "results": [
    {
      "@type": "Product",
      "@id": "https://example.com/products/mug-001",
      "url": "https://example.com/products/mug-001",
      "name": "軽量マグ",
      "description": "食洗機対応。重さ180gの軽量マグカップです。",
      "grounding": {
        "source_urls": [
          "https://example.com/products/mug-001"
        ]
      }
    }
  ]
}
画面側が見るのは、候補の配列resultsです。その中のnameで商品名、urlで商品ページ、descriptionで特徴を確認でき、@idを元データと比べれば同じmug-001を追えます。
変換処理は、検索で取得した商品のURLや名称などを出力し、元の商品オブジェクトの属性も引き継ぎます。grounding.source_urlsには根拠となるURLを入れるため、この例では商品ページを示しています。[6]
つまり、店が用意した「軽量マグ」「食洗機対応」「180g」という情報が、保存と検索を経て候補の表示材料になります。名称・URLを表示し、商品ページへのリンクにする部分は画面側の役割です。この商品が実際に選ばれるか、条件に合わない商品を除外できるかは、検索品質の検証で確かめます。
5. 実装の違いに注意する
同じNLWebの資料でも、queryの型や設定は一致していません。実装担当者へ渡す資料は、動かすリポジトリと版をそろえます。
| 資料 | 質問・返答の違い | 導入上の違い |
|---|---|---|
| Ask Agentの固定版 | queryはtextを持つオブジェクト。返答形式はpreferで指定。[4][7] |
PyPI導入は提供予定。CrawlerはAzure接続に限定。[4] |
| NLWeb_CoreのREADME | POST例のqueryは文字列。[2] |
PyPI導入例と複数の検索用DBを掲載。[2] |
| NLWebのREST API資料 | 会話履歴や別の結果形式を説明。[3] | Ask Agentの送受信形式として転用しない。 |
この記事の返答例は、Ask Agent自身の型と変換処理を根拠にしています。別資料に同じ項目名があっても、設定や返答全体の互換性まで意味するわけではありません。
6. 候補の発見と注文は別
お客さまが軽量マグを見つけ、「これを2個、送料込みで3,000円以内なら買いたい」と入力したとします。この文章を検索APIへ送ることと、在庫や総額を確かめて注文を受け付けることは別です。
例えば1個1,200円なら、2個の商品代は2,400円です。予算内で買えるかどうかは送料などを含めて判断し、在庫の確認、購入内容の提示、本人の購入許可、決済・注文処理へ進める必要があります。
Ask Agentの型定義には、結果に付けられる任意のactionsがあり、説明にはAddToCartActionの例も登場します。ただし、これは操作を記述するためのデータ項目です。特定の店のカートや決済が実装・接続され、購入が成功する根拠にはなりません。[7]
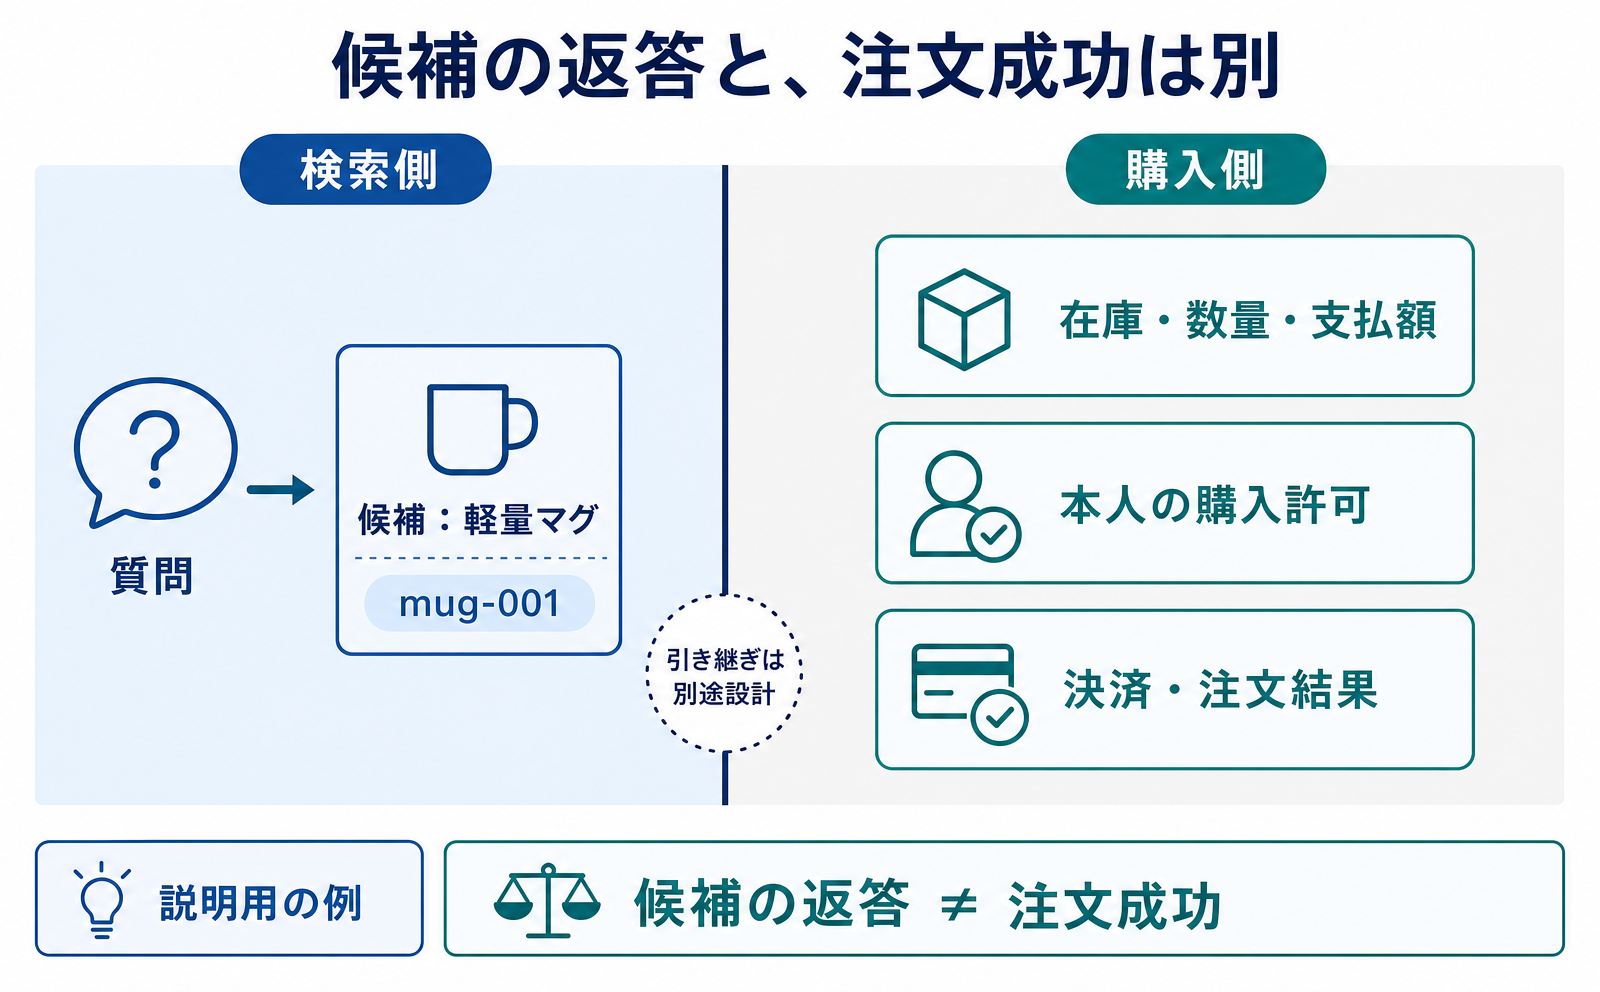
既存のECカートを使うなら、現在の在庫や支払額の確認は購入側で行い、検索結果からどう引き継ぐかを別途設計します。候補の返答ではなく、購入側の注文結果で成否を判断します。
READMEにはMCPの/mcp、A2Aの/a2aも案内されていますが、接続方式への対応だけで予約・注文・決済機能が加わるわけではありません。APIを呼ぶ許可と、お客さま本人の購入許可も区別が必要です。[4]
7. 導入前に確認すること
NLWebが検討対象になるのは、商品名や分類だけでは探しにくく、用途や条件から候補へ案内したい場合です。記事サイトなら、タイトルを知らない読者が知りたい内容から記事を探す入口として考えられます。
最初の確認は、次の3点に絞ると整理しやすくなります。
- 情報を用意できるか: よくある質問に答える商品特徴や記事内容があり、読み込み対象のデータにできるか。
- 品質を確かめられるか: 代表的な質問で、適切な候補・名称・リンクが返り、条件違いの商品をどう扱うか確認できるか。
- 運用を続けられるか: 収集、保存先、AI、画面の担当と費用を決め、更新やエラーに対応できるか。
軽量マグの例なら、まず商品ページと元データに食洗機対応・重量がそろっているかを確認します。そのうえで実装担当者と、データの発見経路、保存された内容、質問への候補返答を順に確かめます。品番の完全一致検索や価格・在庫の絞り込みは、既存機能との役割分担も考えられます。
確認範囲
本稿は固定版のREADME・読み込み処理・型定義・結果変換を基にした解説で、稼働済みの導入手順ではありません。自社データの発見・取り込み設定、更新・削除の反映時間、日本語での検索品質、公開APIの認証・アクセス制限、運用費用は導入環境で確認が必要です。
外部サービスへの実接続や注文・決済の動作検証は含みません。検索改善を目的にするなら商品データと代表的な質問から検討を始め、購入まで任せたいなら別途、注文・決済側の仕様と接続を確認してください。
よくある質問
- Q. NLWebは、管理画面から申し込めば使えるサービスですか?
- この記事で扱うnlweb-ask-agentは、コードを取得して設定・起動する開発用の仕組みです。検索API、Crawler、検索画面などを組み合わせ、商品情報の整備に加えて環境の開発・運用が必要です。固定版のREADMEではPyPI経由の導入は提供予定とされています。[4]
- Q. 商品ページとサイトマップがあれば検索できますか?
- それだけでは判断できません。READMEのドメイン登録例はルートのsitemap.xmlを条件としますが、通常のサイトマップに商品詳細が入るわけではありません。固定版の読み込み処理はJSONオブジェクト・配列、JSONL、TSV、RSSを解析するため、自社の商品詳細をどのデータで渡し、そこへどう到達させるかを別々に確認します。[4][5]
- Q. queryには質問文をそのまま入れればよいですか?
- 実装によって異なります。Ask Agentの固定版ではqueryはオブジェクトで、その中のtextに質問文を入れます。NLWeb_CoreのREADMEにある、queryへ文字列を直接入れる例とは混ぜないでください。[2][7]
- Q. 候補の商品名やリンクは、返答のどこで確認しますか?
- この記事で指定したconv_search形式では、候補一覧はresultsです。固定版の結果変換はname、url、descriptionなどを出力し、元の商品属性も引き継ぎます。本文では必須のメタデータなどを省いた説明用の抜粋を示しており、完全な通信レスポンスではありません。[6][7]
- Q. NLWebだけで注文や決済までできますか?
- 検索の構成だけでは、注文・決済までできるとは判断できません。結果の型には任意のactionsやAddToCartActionへの言及がありますが、特定店舗のカート・在庫・送料計算・購入許可・決済が接続済みであることを意味しません。購入側の仕様と注文結果を別途確認します。[4][7]
- Q. Azure以外でも使えますか?
- 対象の部品とリポジトリで異なります。NLWeb_Coreは複数の検索用データベースを挙げていますが、この記事のAsk Agent固定版では、Crawlerの接続先はAzureに限定され、別の保存先を選ぶ設定には未対応と記載されています。[2][4]
- Q. 前の質問を踏まえて会話を続けられますか?
- Ask Agentの固定版の型には、過去の質問などを渡すcontextの定義があります。ただし、本稿が説明するのは単発の質問から候補を得る流れです。会話を継続する処理や画面での動作、日本語での品質は検証対象に含めていません。[7]
出典・参考データ
- [1] nlweb-ask-agent README(main・初回参照資料) (nlweb-ai) — 取得 2026-09-10
- [2] NLWeb Core README (nlweb-ai) — 取得 2026-09-10
- [3] NLWeb Rest API (nlweb-ai) — 取得 2026-09-10
- [4] nlweb-ask-agent README(固定コミット065581c) (nlweb-ai) — 取得 2026-09-10
- [5] Ask Agent Crawler worker.py(固定コミット065581c) (nlweb-ai) — 取得 2026-09-10
- [6] Ask Agent ranked_result.py(固定コミット065581c) (nlweb-ai) — 取得 2026-09-10
- [7] Ask Agent protocol/models.py(固定コミット065581c) (nlweb-ai) — 取得 2026-09-10
この記事を書いた人
水島 翔吾株式会社kairos 代表取締役 / AgentSignal 開発者
AI クローラー・AI 流入計測と AIO 診断ツール AgentSignal を開発。実測データを元に AI 検索時代の計測と対策を書いています。
関連記事
計測・サイト改善
AIクローラーとは?GPTBotを止めてもChatGPT検索に出る理由
AIクローラーは、AI企業が公開ページを読むためのプログラムです。GPTBotとOAI-SearchBotの違い、Google-Extendedの扱い、robots.txtで断っても訪問が続く理由、目的別の設定の決め方を説明します。
公開
AIによる販売・予約
ChatGPTに商品を載せるには?ACPの商品連携から注文まで
ChatGPTに商品を載せたいEC担当者向けに、商品連携の申請、承認後のデータ送信、価格・在庫の更新、購入ページへの案内を順に説明。注文APIが必要になる条件を確認してから、2026-04-17版の実装とテストへ進みます。2026年9月10日時点の提供条件・提案段階の仕組みも明記します。
公開
AIとWebの連携
WebMCP対応のフォームが「合格」に。Lighthouse 13.5で変わった診断の読み方
Lighthouseは、Webサイトの状態を調べるツールです。今回の変更では、AIに操作を伝えるWebMCPのフォーム対応を、診断結果から読み取りやすくなります。
公開