AIクローラーとは?GPTBotを止めてもChatGPT検索に出る理由
AIクローラーの学習用・検索用の違いと、GPTBotを止めてもChatGPT検索の対象になる理由を解説。Google-ExtendedとSearch Consoleの生成AI設定、ClaudeBotの学習拒否、既存の除外ルールを残すrobots.txtの例も紹介します。制作会社への依頼文と変更後の確認方法も示します。
AIクローラーとは、AI企業が公開されているWebページを自動で読みに来るプログラムです。 学習のため、検索で紹介するため、利用者に頼まれてその場で読むため、と目的ごとに別の名前が付いています。そのため、GPTBotを止めても、ChatGPTの検索用のプログラムは別に設定できます。[1]
「記事をAIの学習には使われたくないけれど、商品を探す人にはAIから紹介してほしい」。この方針なら、学習用と検索用の設定を分けて確かめます。Googleでは、ページの取得と検索の生成AI機能への掲載も別の設定です。
確認日:2026年11月16日。
AIクローラーとは:AI企業が公開ページを読むプログラム
AIクローラーの主な目的は、学習・検索・利用者の依頼による取得の3つです。 同じ会社でも、目的ごとに名前が違います。
クローラーとは、Webページを自動で巡回して読むプログラムのことです。サイト側は、robots.txt というサイトの直下に置く設定ファイルで、名前ごとに「読んでよい」「読まないでほしい」を伝えます。
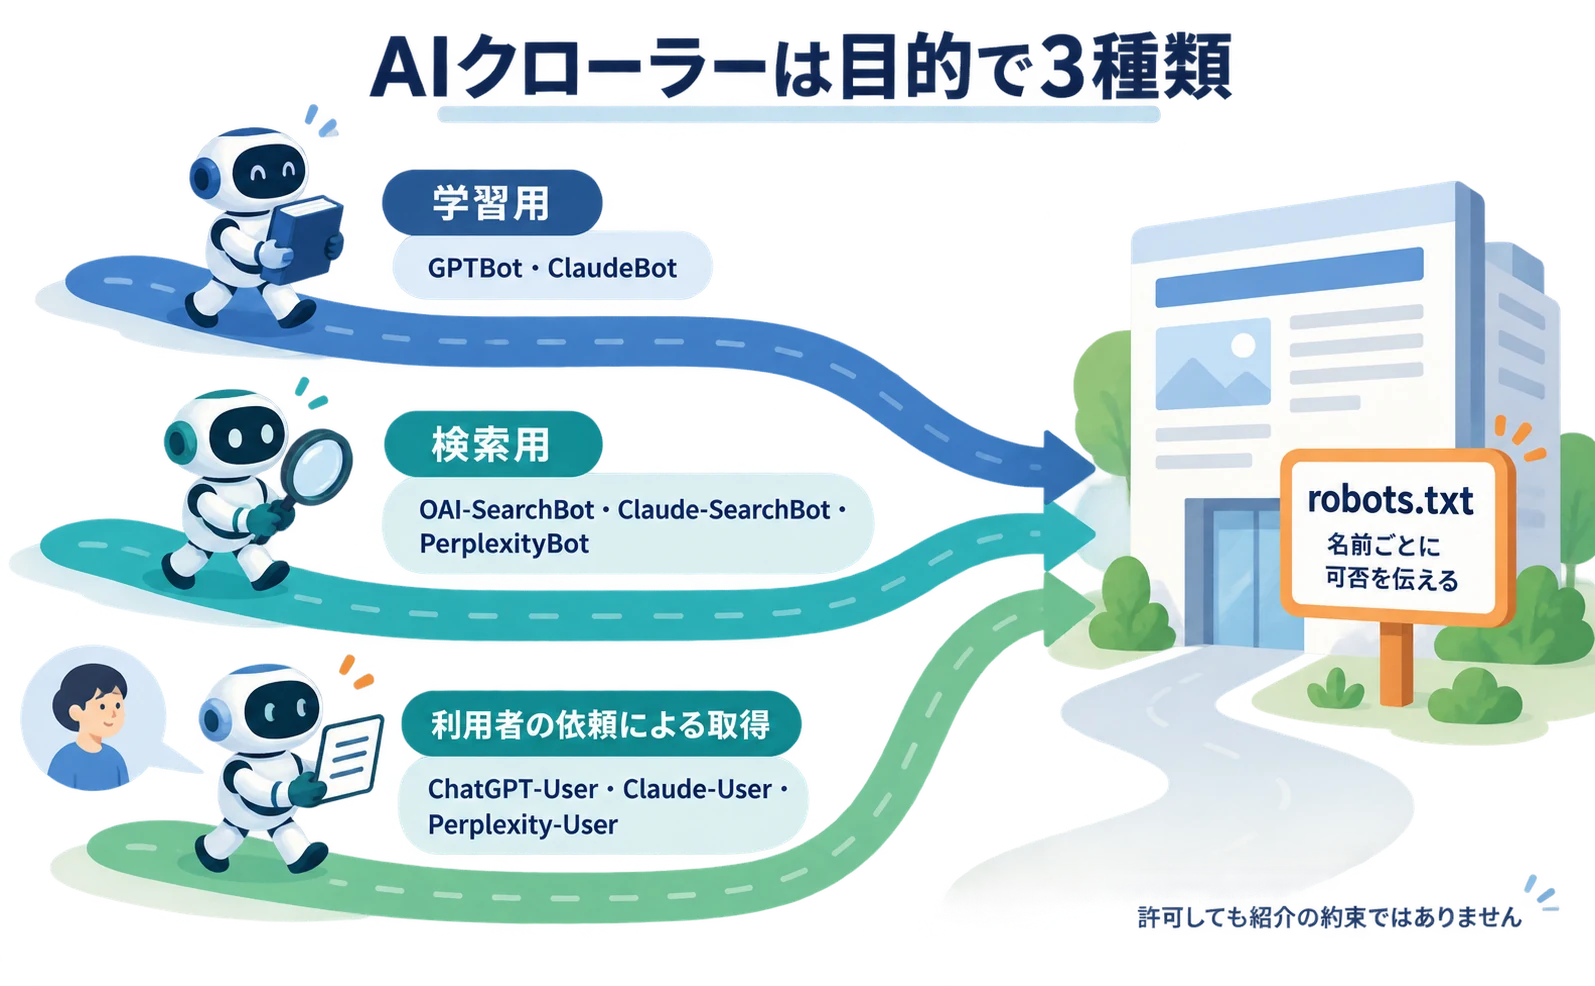
| 目的 | 主な名前(提供元) | 止めたときの主な影響 |
|---|---|---|
| 学習用 | GPTBot(OpenAI)、ClaudeBot(Anthropic) | 今後の内容を学習に使わないでほしいという意思表示になる |
| 検索用 | OAI-SearchBot(OpenAI)、Claude-SearchBot(Anthropic)、PerplexityBot(Perplexity) | そのAIの検索で紹介されにくくなる |
| 利用者の依頼による取得 | ChatGPT-User(OpenAI)、Claude-User(Anthropic)、Perplexity-User(Perplexity) | 利用者に頼まれた読み取りに影響する。ChatGPT-UserとPerplexity-Userはrobots.txtが効かない場合がある(Claude-Userは従うと説明) |
出典:[1][2][3]を基に整理
PerplexityBotは検索結果での表示用で、AIの学習には使わないと説明されています。[3] Anthropicの3種類はrobots.txtに従い、読み込み間隔を指定する Crawl-delay にも対応しています。[2]
「許可」は訪問を受け入れることで、紹介される約束ではありません。「拒否」も、過去に集められた情報まで消すものではありません。
ClaudeBotの学習拒否は、個別の指定を先に確認する
ClaudeBotのルールを明示している場合は、共通の学習拒否設定より、その個別ルールが優先されます。 Anthropicは2026年10月30日から、複数のAI事業者へ学習拒否を伝える共通信号への対応を始めたと説明しています。ただし、各サービスへの反映は段階的です。[2]
共通信号は、インターネットの技術仕様を議論するIETFの「aipref」草案に沿うもので、仕様自体も検討中です。ClaudeBotの指定がなければ共通信号を使うという説明であり、すべてのAI事業者に同じ設定が効くという意味ではありません。[2]
学習を断る方針なら、まず現在のrobots.txtにClaudeBotを許可する指定が残っていないかを確かめます。共通の設定を追加しただけで完了とせず、個別の指定と方針が食い違わないようにします。
GPTBotとOAI-SearchBotは別設定:ChatGPT検索への影響
GPTBotは学習用、OAI-SearchBotはChatGPTの検索用で、OpenAIは両者の設定を独立して扱っています。 GPTBotを拒否しても、OAI-SearchBotを許可していれば、ChatGPTの検索の対象から外れるわけではありません。[1]
OpenAIは例として、「OAI-SearchBotを許可して検索結果に出しつつ、GPTBotを拒否して学習には使わないよう示す」設定を挙げています。[1]
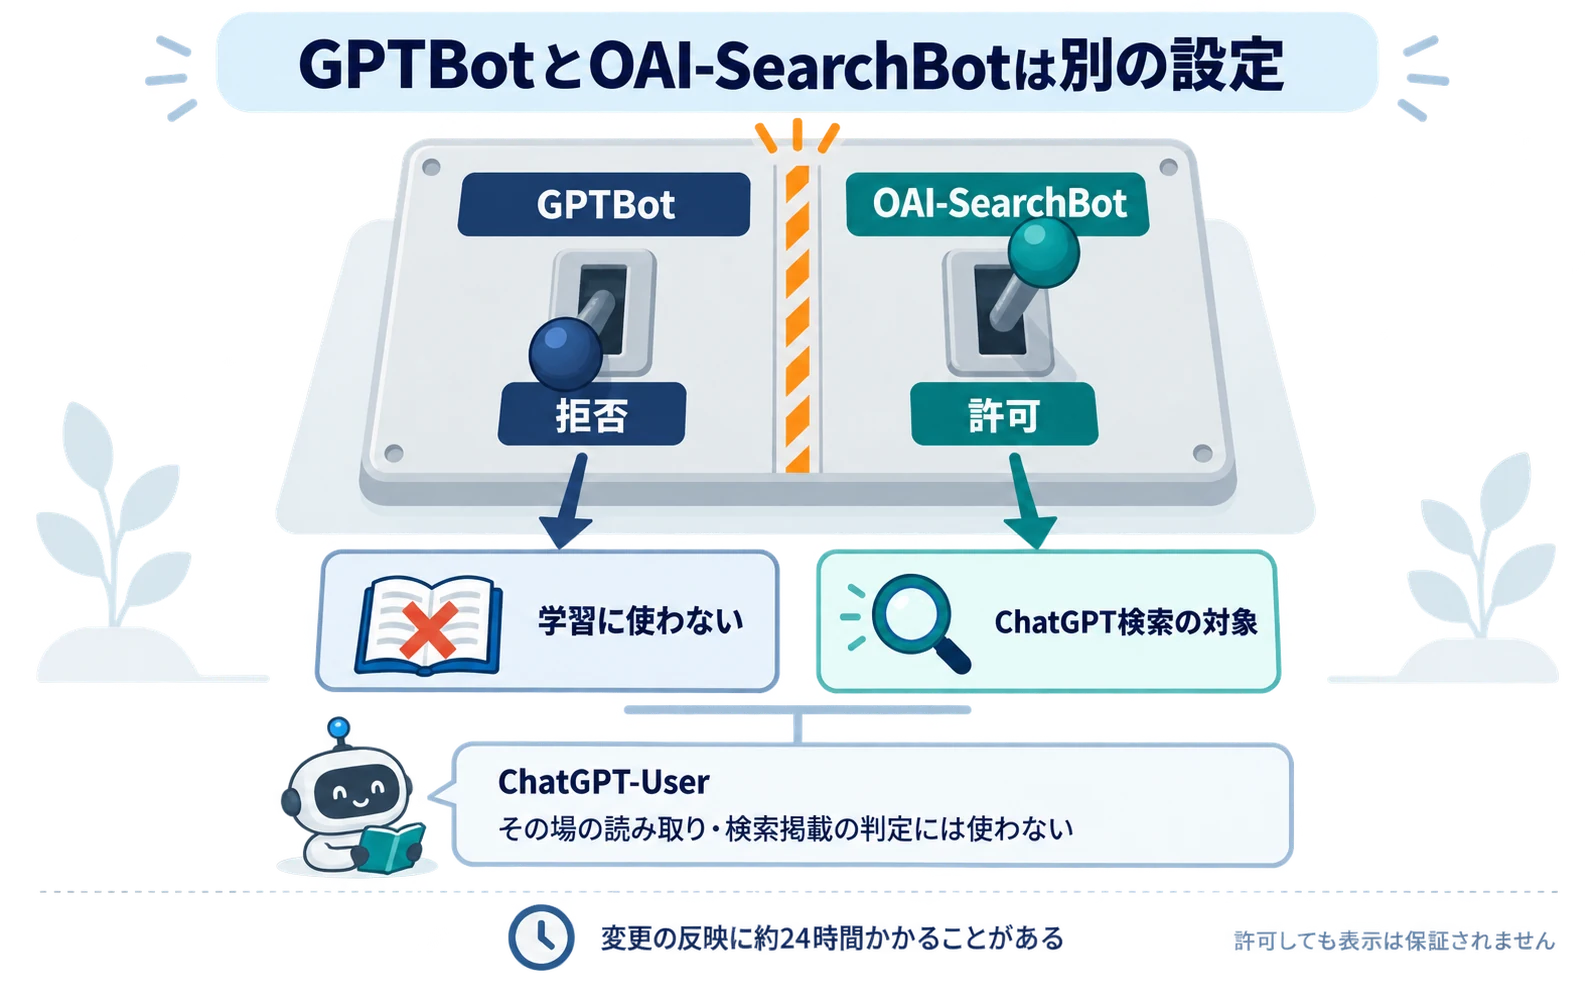
反対に、OAI-SearchBotを拒否したサイトは、ChatGPTの検索の回答には表示されません。ただし、サイトへの案内用のリンクとしては出ることがあります。[1]
ChatGPTの検索に出したい場合、OpenAIはOAI-SearchBotをrobots.txtで許可し、公開しているIPアドレスの範囲からのアクセスも許可するよう勧めています。IPアドレスは、アクセス元のコンピューターを表す番号です。[1]
robots.txtを書き換えてから、OpenAIの検索のシステムに反映されるまで、約24時間かかることがあります。[1] 変更した直後の結果だけで判断しないようにします。
ChatGPT-Userは検索掲載の判定に使われない
ChatGPT-Userは、利用者がChatGPTに質問したときなどに、その場でページを読むためのアクセスです。 検索に表示するかどうかの判定には使われません。[1]
利用者の操作で始まるアクセスのため、robots.txtのルールが適用されない場合があるとOpenAIは説明しています。検索への表示と自動の巡回を管理するには、OAI-SearchBotの設定を使うよう案内しています。[1]
そのため、「ChatGPT-Userを止めればChatGPT検索から消える」「ChatGPT-Userを許可すれば検索に出る」とは考えません。
Google-ExtendedとGoogle検索のAI機能は別の設定
Google-Extendedを拒否しても、Google検索やAIによる概要への掲載には影響しません。 学習への利用、検索の生成AI機能への掲載、ページの取得は、それぞれの設定で確かめます。[4][7]

Google-Extendedは学習やGeminiの回答への利用を管理する
Google-Extendedは、将来のGeminiモデルの学習と、Geminiアプリなどが回答の根拠として内容を使うことを管理する設定です。Googleは、検索への掲載や順位には影響しないと明記しています。[4]
また、Google-Extendedという名前の訪問は、アクセス記録に現れません。ページの取得には既存のGoogleのプログラムが使われ、Google-Extendedはrobots.txtの中で制御用の名前として働きます。[4]
Google-Extendedを拒否した後もGooglebotの訪問がある、というだけでは設定の失敗とは判断できません。学習などへの利用を管理する設定と、検索用にページを読む動きを分けて見ます。
Search Consoleで検索の生成AI機能への掲載を選ぶ
AIによる概要やAIモードへの掲載を外したい場合は、Search Consoleの「設定」から「検索の生成 AI」を確認します。 日本語の公式ヘルプには、2026年8月31日から世界中のサイトで利用できると案内されています。[7]
ここでは、対象の生成AI機能に含める、除外する、親の設定を引き継ぐ、という選択ができます。対象にはDiscoverの生成AI機能も含まれますが、通常の検索の掲載資格や順位、AIの学習への利用は変更しません。[7]
反映には通常数日かかり、画面上で有効になった後も、保存済みの結果が残る場合があります。[7] 親から設定を引き継ぐ場合の確認は、Googleの「優先ソース」と検索の生成AI設定の解説も参考になります。
Googlebotの取得と、検索結果の説明文の設定も確かめる
Googlebotをrobots.txtで拒否すると、通常のGoogle検索に必要なページの取得にも影響します。検索の生成AI機能への掲載だけを外したい場合は、Googlebotをまとめて遮断する前に、上のSearch Consoleの設定を確認します。[4][7]
表示する文章を制限する nosnippet や max-snippet は引き続き利用できます。ただし、これらは通常の検索結果の説明文にも影響するため、生成AIの回答だけを対象とする設定とは区別します。[5]
検索全体からページを外す場合は noindex、情報そのものを非公開にする場合はログインなどのアクセス制限を検討します。[6] 「AIに出したくない」がどの範囲を指すのかを、設定を変える前に決めておきます。
robots.txtで断ってもAIクローラーが来るときの確認
拒否した後もアクセスが続くときは、反映の時間差、利用者の依頼による取得、名前の偽装の3つを確かめます。
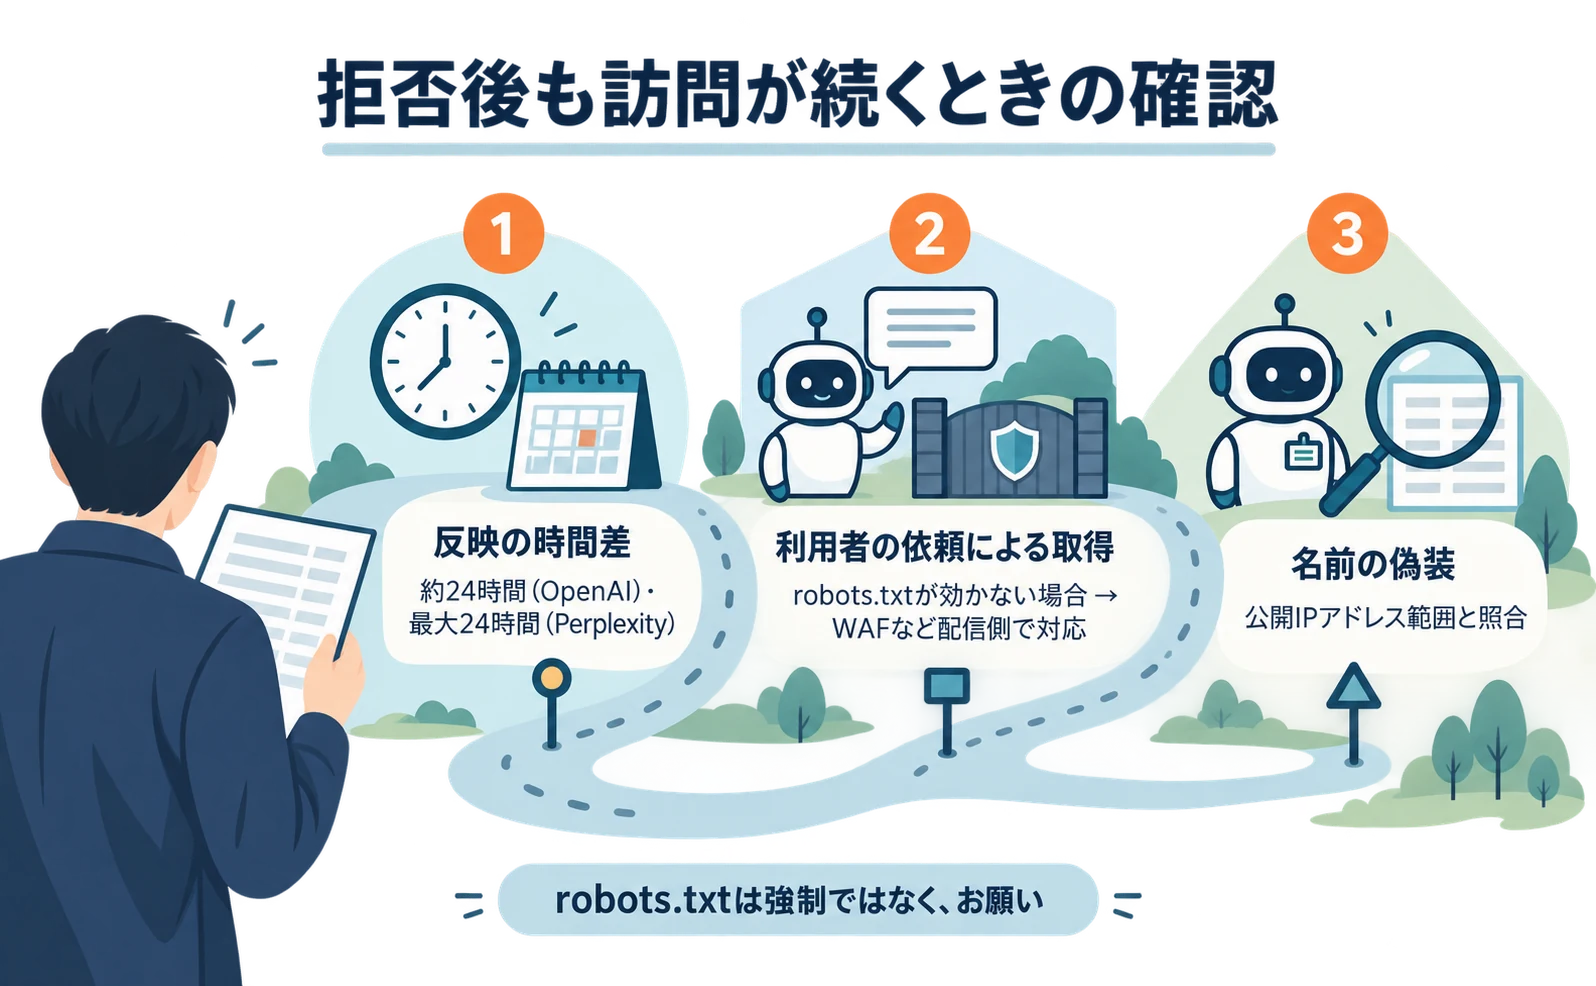
- 反映の時間差。 OpenAIは約24時間、Perplexityは最大24時間かかることがあると説明しています。[1][3] 変更した日時と、その後の訪問の日時を並べて見ます。
- 利用者の依頼による取得。 Perplexity-Userは、利用者に頼まれた取得のため、一般にrobots.txtを無視すると説明されています。[3] ChatGPT-Userも適用されない場合があります。[1] 止めたい場合は、WAF(不正なアクセスを止めるサービス)など配信側の設定が必要です。
- 名前の偽装。 訪問時に名乗る名前は偽装できます。[4] OpenAIやPerplexityが公開しているIPアドレスの範囲と照合して、本物かを確かめます。[1][3]
なお、robots.txtは「読まないでほしい」というお願いで、従うかどうかはクローラー次第です。Googleも、robots.txtは検索結果に出さないための仕組みではなく、非公開にしたい情報はパスワードなどで守るよう説明しています。[6]
Anthropicは、IPアドレスでのブロックでは確実に拒否できない場合があるとし、robots.txtでの設定を案内しています。[2] 会社ごとに推奨する方法が違う点にも注意します。
名乗りの真偽を確かめる仕組みはWeb Bot Authの解説で詳しく紹介しています。
AIクローラーの設定を決めて制作会社に依頼する
まず目的別に許可・拒否を決めた表を作り、対象サイト・対象ボット・変更前後の記録を含めて依頼します。
「AI対策をお願いします」だけでは、学習を断りたいのか、検索に出したいのかが伝わりません。次のように方針を一行ずつ書きます。
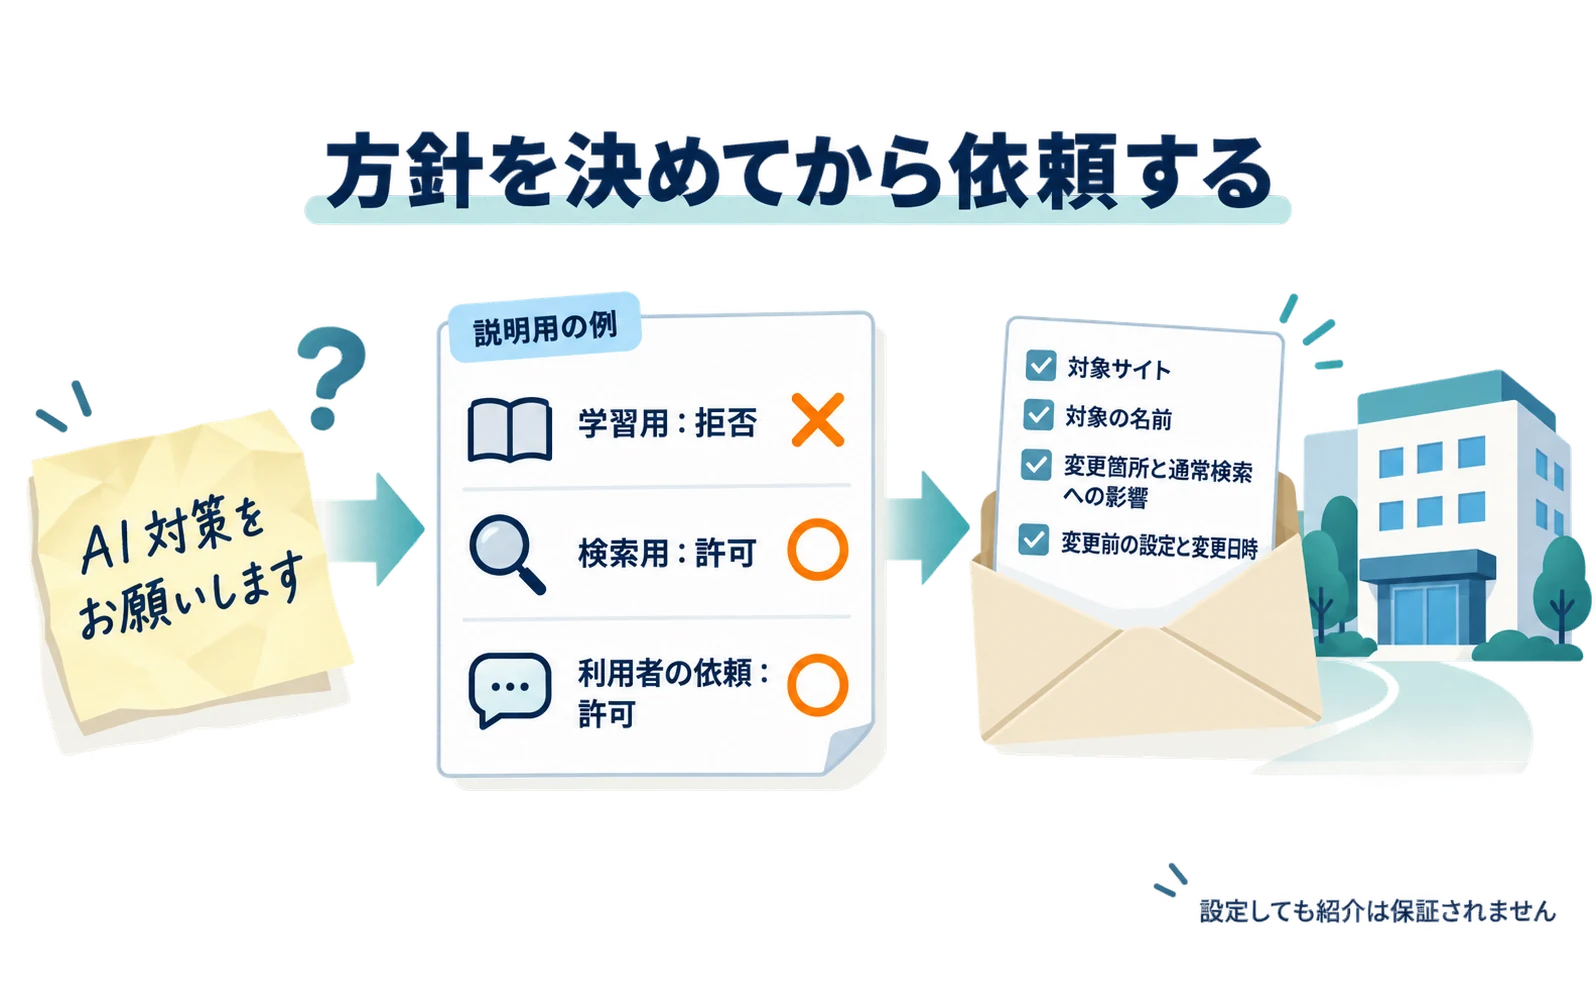
| 方針(説明用の例) | 学習用 | 検索用 | 利用者の依頼 |
|---|---|---|---|
| 学習は断り、検索での紹介は受け入れる | 拒否 | 許可 | 許可 |
| 学習も検索も受け入れる | 許可 | 許可 | 許可 |
| Anthropicの取得間隔を空ける | Crawl-delayを検討 | Crawl-delayを検討 | Crawl-delayを検討 |
3行目はAnthropicが対応を明記している設定です。[2] すべての検索ボットに共通して使える指定ではなく、Googleは Crawl-delay に対応していません。[8]
robots.txtの例は、既存の除外ルールを残して使う
一行目の方針なら、robots.txtは例えば次のようになります。これは相談用の例で、自社の既存の設定と合わせて制作会社に確かめてもらいます。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Disallow: /admin/

User-agent: Claude-SearchBot
Disallow: /admin/

User-agent: PerplexityBot
Disallow: /admin/

User-agent: *
Disallow: /admin/
この例では、検索用の各ボットも /admin/ を除外し、それ以外の公開ページは取得できる形にしています。Googleの仕様では、対象の名前に一致する個別グループと * のグループは足し合わされません。[8] そのため、共通グループだけに書いた除外指定が個別グループにも効くとは考えず、既存の除外対象を一つずつ確認します。
これは管理画面を安全にする仕組みではありません。非公開ページにはログインなどのアクセス制限も必要です。[6]
また、Anthropicのrobots.txtはサブドメインごとに設定します。[2] 本体のサイトだけを変えて、別のホストにあるヘルプや商品ページの設定を残さないようにします。
変更後は、設定・ページ取得・AI回答を分けて確かめる
依頼には、CDN(ページの配信を助けるサービス)やWAFの確認も含めます。robots.txtで許可していても、配信側で拒否していればページを取得できないためです。依頼文は、例えば次のようにまとめられます。
対象サイトのAI向けアクセス設定を見直したいです。学習用の取得は拒否し、公開している商品ページが検索で紹介されるための取得は受け入れたいと考えています。
現在のrobots.txtと、CDNやWAFでの制限を確認してください。変更前に、対象の名前、変更する箇所、通常の検索への影響を教えてください。変更前の設定は保存し、変更日時を記録してください。
変更後は、対象のrobots.txtが読めるか、公開ページと除外対象へのアクセスが方針どおりか、変更日時以降の記録で確かめます。Googleの生成AI設定も変えた場合は、Search Consoleに表示される設定と反映状況を別に確認します。
設定を変えても、AIの回答に紹介されるとは限りません。紹介されるかは、実際の質問への回答で別に確かめます。AI向けのリンク集であるllms.txtとrobots.txtの違いはllms.txtは必要?で説明しています。
よくある質問
- Q. GPTBotをブロックするとChatGPTの検索に出なくなりますか?
- GPTBotは学習用で、ChatGPTの検索に使われるOAI-SearchBotとは別の設定です。GPTBotを拒否しても、OAI-SearchBotを許可していれば検索の対象から外れるわけではありません。許可しても表示は保証されません。
- Q. Google-Extendedを拒否するとAIによる概要に出なくなりますか?
- Google-Extendedの拒否だけでは外れません。Google検索の掲載に影響しないためです。AIによる概要やAIモードへの掲載を外したい場合は、Search Consoleの「設定」にある「検索の生成 AI」を確認します。
- Q. GPTBotと名乗るアクセスは本物ですか?
- 名乗る名前は偽装できます。OpenAIが公開しているIPアドレスの範囲と照合して確かめます。
出典・参考データ
- [1] Overview of OpenAI crawlers (OpenAI) — 取得 2026-11-16
- [2] Does Anthropic crawl data from the web, and how can site owners block the crawler? (Anthropic) — 取得 2026-11-16
- [3] Perplexity Crawlers (Perplexity) — 取得 2026-11-16
- [4] Google の一般的なクローラーのリスト (Google Search Central) — 取得 2026-11-16
- [5] AI 機能とウェブサイト (Google Search Central) — 取得 2026-11-16
- [6] robots.txt の概要 (Google Search Central) — 取得 2026-11-16
- [7] 検索の生成 AI 設定 (Google Search Console ヘルプ) — 取得 2026-11-16
- [8] Google による robots.txt の指定の解釈 (Google for Developers) — 取得 2026-11-16
この記事を書いた人
水島 翔吾株式会社kairos 代表取締役 / AgentSignal 開発者
AI クローラー・AI 流入計測と AIO 診断ツール AgentSignal を開発。実測データを元に AI 検索時代の計測と対策を書いています。
関連記事
計測・サイト改善
GPTBotを名乗るアクセスは本物?Web Bot Authの仕組み
GPTBot と名乗るアクセスが来ても、名前だけでは本物か分かりません。接続元の IP や、通信に付いた署名を確認する方法があります。Web Bot Auth と RFC 9421 の違い、2026年9月時点の草案と各社の対応を整理します。公式の IP 一覧との照合、未確認の記録の残し方、署名の有無と検証成功の違いを、制作会社へ頼む際の確認表とともに説明します。
公開
AIO・AI検索対策
llms.txtは必要?できることと、設置前に確認したいこと
llms.txtは、AIに読んでほしい公開ページをまとめたリンク集です。AI検索で必須かどうか、robots.txtとの違い、役立つ場面、書き方、WordPressなどでの設置と点検方法を説明します。
公開
AIO・AI検索対策
LLMOとは?SEOとの違いと、意味がないと言われる理由
LLMOは、ChatGPTなどの回答で自社が見つかり正しく紹介されるための取り組みです。SEOとの違い、「意味ない」と言われる理由、E-E-A-Tとの関係、効果の測り方と最初の1か月の作業を説明します。
公開