Content Signalsとは?検索利用とAI学習を分けて伝える方法
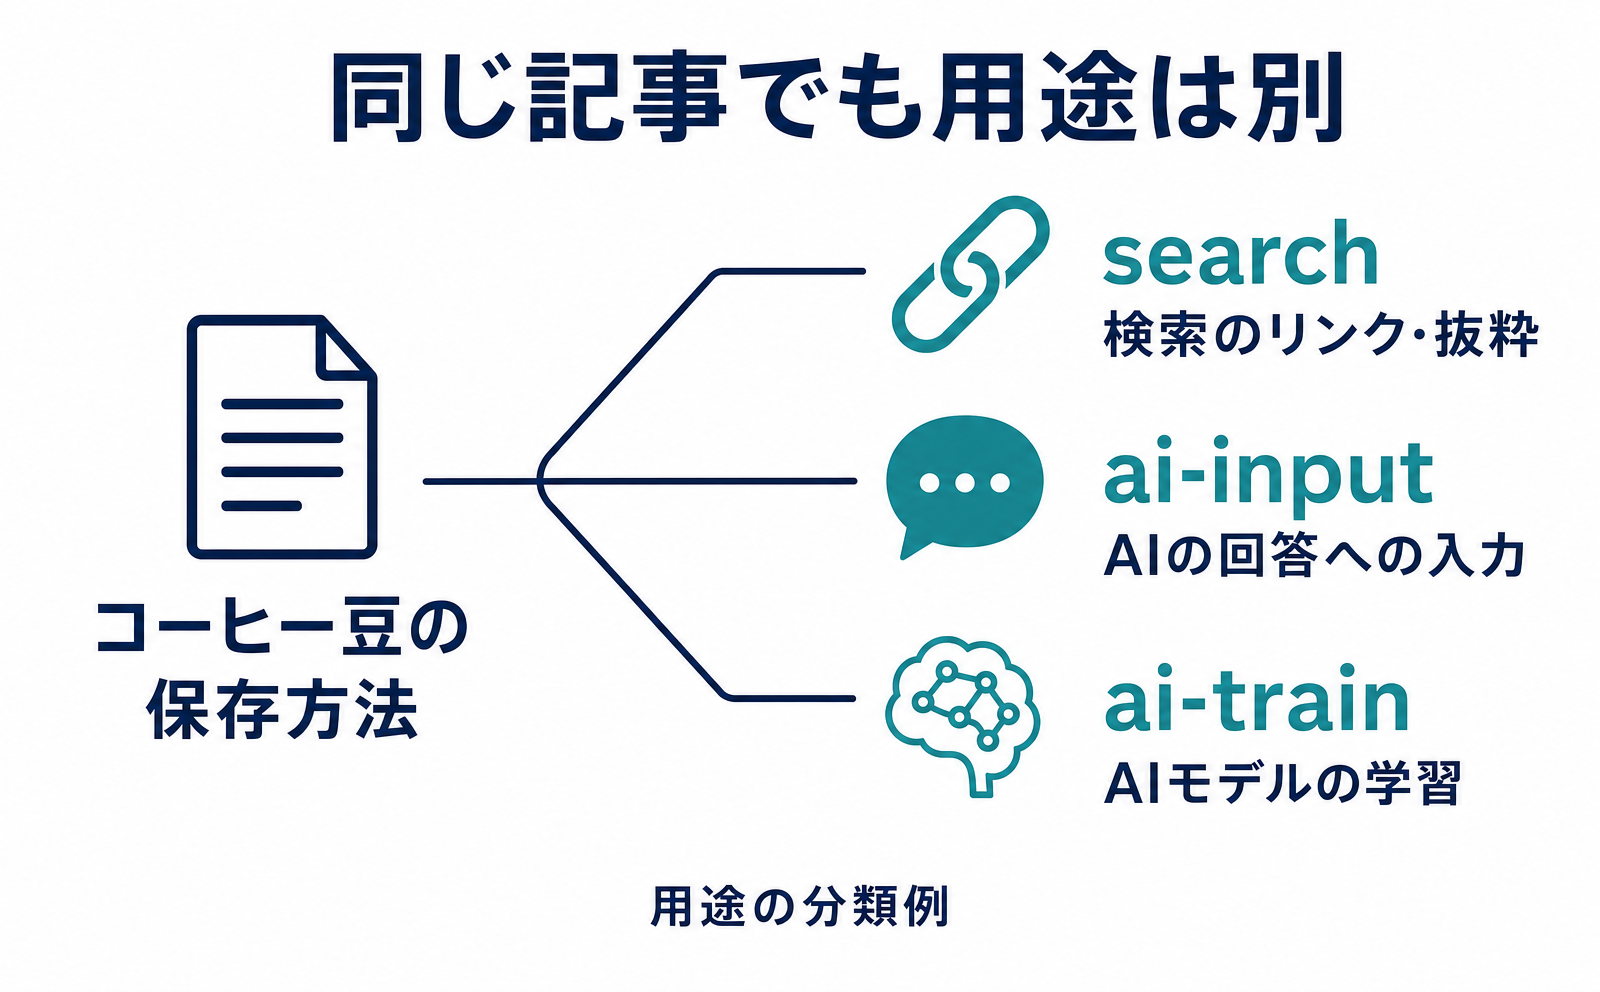
検索には使ってほしいが、AI学習への使用は断りたい。Content Signalsの3用途とrobots.txtへの記載例を解説します。未記載の意味、取得制限との違い、Cloudflareの管理機能、設定後の確認ポイントを整理します。
Content Signalsは、サイトの記事を「検索には使ってよいが、AI学習には使わないでほしい」と用途別に伝える仕組みです。検索からの来訪を期待しつつ、自社コンテンツのAI利用方針を示したいサイト・EC運営担当者に役立ちます。基本の用途指定は、search=yes, ai-train=noです。[1]
ただし、用途を宣言することと、クローラーのアクセスを止めることは別です。この記事では、コーヒー豆を販売する店の「豆の保存方法」という記事を例に、書き方から配信後の確認までを説明します。
1. 同じ記事でも用途を分ける
Content Signalsは、ドメイン直下のrobots.txtに書く、機械が読める用途の指示です。サイト運営者が利用方針を示し、記事を収集するクローラーの運営者が、その指定に対応する関係になります。[1]
例えば、コーヒー豆の店が保存方法の記事を公開しているとします。これは説明用の例ですが、「検索結果に記事のリンクを出してほしい」「記事をAIモデルの学習材料にすることは断りたい」という二つの希望は、分けて指定できます。
さらに、AIが記事を参照して、その場で保存方法を回答する用途も別に扱います。「AIに使わせるか」という一つの判断ではなく、検索・回答への入力・学習の三つに分けられることが利点です。
| 項目 | 指定する用途 | 保存方法の記事での例 |
|---|---|---|
search |
検索インデックスの作成と、リンクや短い抜粋を含む検索結果の提供 | 「コーヒー豆 保存方法」の検索結果に記事のリンクを載せる |
ai-input |
AIモデルへの入力。検索で取得した情報を使う回答生成など | AIが記事を参照し、保存方法についてその場で回答する |
ai-train |
AIモデルの学習や追加学習 | 記事をモデルの学習材料にする |
この定義でのsearchには、AIが生成する検索要約は含まれません。検索サービス内の機能であっても、search=yesを「AIによる回答作成まで一括して許可する」と読むことはできません。[1]
また、クローラーが記事を取得したという事実だけでは、その場の回答に使ったのか、モデルの学習に使ったのかは分かりません。用途の区分と、実際の取得記録は分けて考えます。
2. 検索は許可し、学習は断る書き方
基本の指定を、公式例にあるクローラーの指定と合わせると次の形になります。これは用途の説明に必要な部分だけを抜き出したもので、既存のrobots.txtを置き換える完成ファイルではありません。[1]
User-Agent: *
Content-signal: search=yes, ai-train=no
User-Agent: *は、すべてのクローラーを対象とするグループを示します。その下のContent-signal:に、そのグループ向けの用途指定を記載します。個別のクローラー向けグループや既存の取得ルールがある場合は、それらも含めて確認が必要です。
| 記載 | 意味 |
|---|---|
User-Agent: * |
すべてのクローラーを対象とするグループ |
search=yes |
検索用途のための収集を許可する意思表示 |
ai-train=no |
学習・追加学習用途のための収集を禁止する意思表示 |
ai-inputは未記載 |
回答への入力について、この仕組みによる許可も制限も示さない |
公式の管理内容には、このほかに用途の定義や権利留保を記した方針文、Allow: /、個別のAIクローラー向けのDisallow、試験中のuse=referenceも含まれます。上の例では、それらを省いています。[1]
保存方法の記事を扱う場合、受け手の読み方は次のようになります。これは指定に対応するクローラーを前提とした説明です。
- クローラーが店の
robots.txtを取得する。 - 自分に対応するグループの取得ルールと用途指定を読む。
- 用途指定から「検索用の収集は許可、学習用の収集は禁止、回答への入力は意思表示なし」と読み取る。
ここで示しているのは、店が伝える利用条件です。検索用途がyesでも、別の取得ルールやサーバー側の遮断があれば、記事を取得できるとは限りません。
未記載は許可でも禁止でもない
ai-inputを省略しても、回答への入力を禁止したことにはなりません。 公式説明では、未記載の用途については、Content Signalsによる許可も制限も示さない扱いです。[1]
店が「保存方法をAIがその場で回答するための入力には使ってよい」と決めるなら、用途指定は次のように書き分けられます。これも公式の項目と値を使った説明用の抜粋です。
User-Agent: *
Content-signal: search=yes, ai-input=yes, ai-train=no
回答への入力も断りたいなら、ai-input=noを選びます。「学習を断る」という合意だけで設定を終えず、回答への入力を認めるかどうかも担当者間で決めておくと、意図が曖昧になりません。
3. 取得ルールと用途宣言は別
robots.txtのAllowやDisallowは、どの場所を取得してよいかを伝えるルールです。一方、Content Signalsは、内容を何のために収集・利用してよいかを伝えます。同じファイルにあっても、役割が異なります。[1]
保存方法の記事について、ai-train=noは「学習目的では収集しないでほしい」という用途の指定です。記事のパスをDisallowにすることや、特定のクローラーからの要求をサーバー側で遮断することとは同じではありません。
| 手段 | 主に決めること | 技術的なアクセス遮断 |
|---|---|---|
| Content Signals | 何の用途で収集・利用してよいか | 記載自体では行わない |
robots.txtの取得ルール |
どのパスを取得してよいか | 記載自体では行わない |
| AI Crawl Controlなどの遮断機能 | 対象の取得要求を通すか | 別の機能で実施する |
Cloudflareは、robots.txtの遵守は任意であり、指示を無視するクローラーもあり得ると説明しています。取得そのものを止める必要があるなら、用途宣言に加えて、AI Crawl Controlなどの遮断機能を検討します。[1]
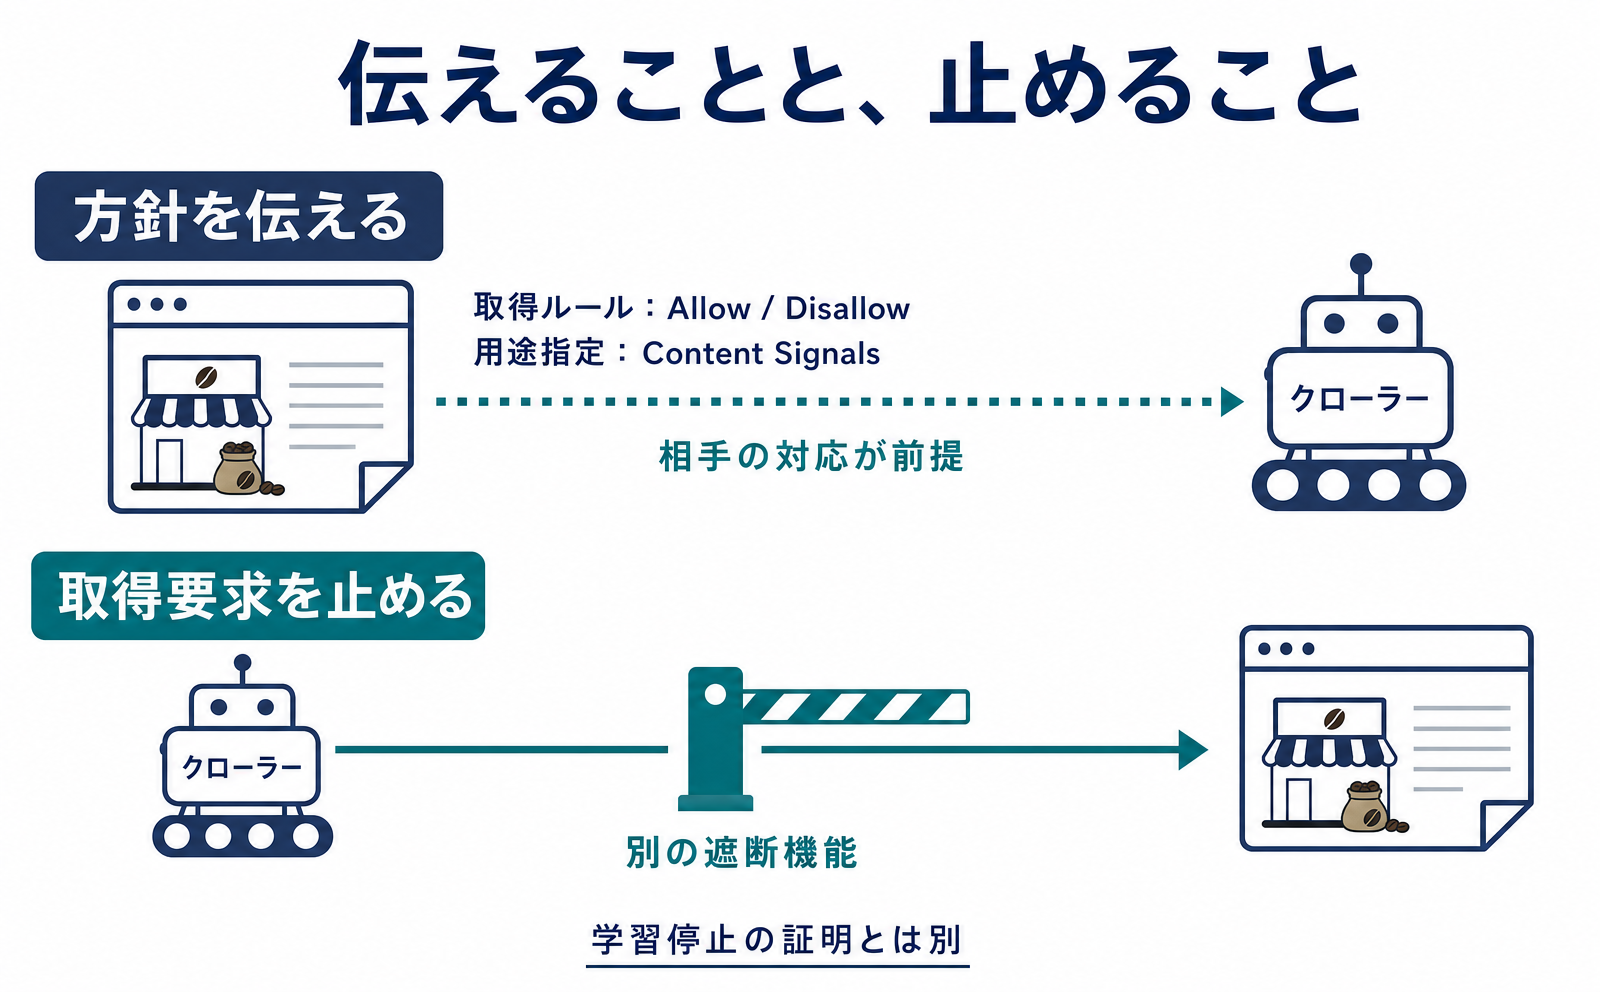
店が検索からの来訪を維持したい場合は、遮断対象にも注意が必要です。「学習を断る方針」と「どのクローラーの取得を止めるか」を別々に決め、配信されるルールが両方の意図に合うかを確認します。
4. Cloudflareに管理させる場合
Content Signalsの用途指定と、Cloudflareが提供する管理機能は区別して考えます。Cloudflareの管理対象robots.txt機能は全プランで提供され、用途指定に加えて、既知のAIクローラー向けの取得禁止ルールも配信します。[1]
既存のrobots.txtがHTTP 200で返る場合、Cloudflareは管理内容をその前に追加し、一つの応答として返します。既存ファイルがない場合は、既知のAIクローラー向けのDisallowを含む新しいファイルを作って配信します。[1]
そのため、有効化を「ai-train=noを1行足す操作」と考えないことが重要です。保存方法の記事をAIの回答への入力には使ってほしい場合も、個別クローラー向けの取得禁止が、その希望と両立するかを確認します。
公式の設定経路
公式説明に記載された操作経路は、次のとおりです。[1]
- Cloudflareダッシュボードで対象ドメインのSecurity Settingsを開く。
Bot trafficで絞り込む。Set your preference to block training in robots.txtを有効にする。
設定後は、対象ドメインの/robots.txtを開き、実際に返る本文を確認します。管理部分の用途指定だけでなく、個別クローラー向けのDisallowと元のファイルの内容も、まとめて見る必要があります。
定義だけの表示に注意
公式説明では、独自のrobots.txtがなく、管理機能も使っていないFreeプランのドメインでは、クローラーがrobots.txtを要求するとContent Signals Policyを表示します。このポリシーは用途の定義を示すもので、個別の許可・禁止は指定しません。[1]
「AI学習とは何か」という説明文が見えるだけでは、ai-train=noを配信しているとはいえません。確認すべきなのは、Content-signal:の行に自社が意図した項目と値があるかどうかです。
use=referenceは試験中の拡張
2026年8月3日更新の公式説明では、Cloudflareはcontent-useという任意の拡張を試験しています。これは取得後の内容の保持や再利用について示す第4の項目で、管理機能を有効にした利用者向けにはuse=referenceを追加するとしています。[1]
同ページでのuse=referenceは、インデックス化、抜粋、リンクの提示を表します。基本の3用途とは別の追加項目なので、実際の管理内容を確認するときは、この指定も含めて読みます。
5. 配信後に何を確認するか
設定後の確認は、まず「意図したファイルが配信されているか」、次に「どのような取得要求が来ているか」の順で進めます。CloudflareのAI Crawl ControlにあるDirectivesタブでは、ホスト名ごとのrobots.txtの状況を確認できます。[2]
公式の経路は、ダッシュボードでアカウントとドメインを選び、AI Crawl ControlからDirectivesを開く流れです。要求数、応答状態、Content Signalsの有無などを確認できます。[2]
| 確認すること | 見るポイント |
|---|---|
| ファイルに到達できるか | 応答状態と、失敗した要求の件数 |
| 用途指定があるか | Content Signalsの有無と、実際の本文の項目・値 |
| 取得禁止パスへの要求があるか | Robots.txt violationsのクローラー名、パス、該当ルール |
| 変更後の状況か | 集計期間と、ルールを追加・変更した日 |
成功した要求の集計はHTTPステータス400未満で、HTTP 200だけでなくリダイレクトも含みます。成功件数だけで「意図した本文が返った」と判断せず、配信内容も確認します。[2]
また、Robots.txt violationsが示すのは、取得禁止のパスへの要求です。AI学習への使用を検出した結果ではありません。 この表は現在のルールを過去の要求に照らすため、ルール変更前には問題のなかった要求も違反として表示されることがあります。[2]
例えば、保存方法の記事を今日から取得禁止にすると、昨日の要求が違反として表示される可能性があります。相手が当時の指示を無視したかを判断するには、要求日時とルールの変更日を合わせて見ます。
6. 自社で決める三つのこと
保存方法の記事を検索で見つけてもらい、AI学習への使用は断りたい店なら、出発点はsearch=yes, ai-train=noです。そのうえで、次の三つを決めると、設定担当者に方針を渡しやすくなります。
- 用途:検索・回答への入力・学習について、それぞれ許可か禁止か、または意思表示しないかを決める。
- 取得:用途を伝えるだけでよいか、特定クローラーの取得を技術的に止める必要があるかを決める。
- 配信確認:既存の
robots.txtと管理機能のどちらで配信するかを整理し、最終的な本文と取得ルールを確認する。
Content Signalsが向いているのは、まず用途ごとの方針を明確に伝えたい場合です。学習の停止を証明したい場合や、過去に取得された記事の利用を取り消したい場合まで、記載だけで解決できるとは考えないようにします。
確認範囲と効力
本稿は、2026年9月10日時点で確認対象としたCloudflareの公式説明に基づく基礎解説です。Content Signals本体の標準化段階、W3C・IETFなどによる承認の有無、各クローラーの採用・遵守範囲、試験中のuseと3用途の詳しい組み合わせは未確認です。
Cloudflareの方針文には、EU指令2019/790第4条に基づく権利留保として制限を表す記載がありますが、日本法での効力や個々の事業者への拘束力を保証するものではありません。[1] 配信や取得要求を確認できても、過去の利用状況や学習済みモデルへの影響の除去まで確認できるわけではありません。
よくある質問
- Q. 検索には使ってほしいが、AI学習は断りたい場合はどう書きますか?
- 基本は「User-Agent: *」で対象グループを示し、その下に「Content-signal: search=yes, ai-train=no」と書きます。これは用途指定部分の抜粋で、完成したrobots.txtではありません。既存の取得ルールも確認し、回答への入力を認めるかはai-inputで別に判断します。[1]
- Q. search=yesなら、AIによる検索要約にも使用を許可したことになりますか?
- いいえ。公式説明のsearchには、AIが生成する検索要約は含まれません。記事をAIモデルに入力し、その場の回答生成などに使う用途はai-inputとして分けられています。[1]
- Q. ai-inputを省略すると、禁止になりますか?
- 禁止にはなりません。未記載は、その用途についてContent Signalsによる許可も制限も示していない扱いです。回答への入力を認めるならai-input=yes、断るならai-input=noで方針を示します。[1]
- Q. Cloudflareの管理機能は、学習を断る記載だけを追加しますか?
- いいえ。既知のAIクローラー向けのDisallowなども含みます。2026年8月3日更新の説明では、試験中のcontent-use拡張としてuse=referenceも追加するとされています。既存ファイルがHTTP 200で返る場合は管理内容が前に追加されるため、配信内容全体の確認が必要です。[1]
- Q. Directivesタブの違反件数で、AI学習を検出できますか?
- Robots.txt violationsは、取得禁止パスへの要求を示す表であり、学習への使用を検出するものではありません。現在の取得ルールを過去の要求に照らすため、ルール変更前には問題のなかった要求も違反として表示される場合があります。[2]
- Q. ai-train=noを書けば、日本でも法的にAI学習を止められますか?
- 記載だけで日本法上の効力や個々の事業者への拘束力を保証することはできません。Cloudflareの方針文にはEU指令に基づく権利留保の説明がありますが、日本法での効力は本稿では未確認です。アクセスの技術的な遮断も別の機能で行います。[1]
出典・参考データ
- [1] robots.txt setting(最終更新:2026年8月3日) (Cloudflare) — 取得 2026-09-10
- [2] Directives(最終更新:2026年4月23日) (Cloudflare) — 取得 2026-09-10
この記事を書いた人
水島 翔吾株式会社kairos 代表取締役 / AgentSignal 開発者
AI クローラー・AI 流入計測と AIO 診断ツール AgentSignal を開発。実測データを元に AI 検索時代の計測と対策を書いています。
関連記事
計測・サイト改善
AIクローラーとは?GPTBotを止めてもChatGPT検索に出る理由
AIクローラーは、AI企業が公開ページを読むためのプログラムです。GPTBotとOAI-SearchBotの違い、Google-Extendedの扱い、robots.txtで断っても訪問が続く理由、目的別の設定の決め方を説明します。
公開
AIO・AI検索対策
llms.txtは必要?できることと、設置前に確認したいこと
llms.txtは、AIに読んでほしい公開ページをまとめたリンク集です。AI検索で必須かどうか、robots.txtとの違い、役立つ場面、書き方、WordPressなどでの設置と点検方法を説明します。
公開
計測・サイト改善
AIから来た人は何をしている?流入後の行動を見て入口ページを直す
AI経由の訪問はあるのに、問い合わせにつながらない。そんなときは、入口ページで何が起きているかを録画で確認します。AI経由の訪問だけを録画で絞り込む方法、ページ全体のヒートマップで補う見方、行動別の直し方、修正後の再確認までを説明します。
公開