AIクローラーは新しいページをどう見つける?CloudflareとOpenAIの試験結果を読む

CloudflareとOpenAIが2026年10月15日に公表した共同試験の初期結果を解説します。AIクローラーによるページ発見、不要なURL取得、更新情報、アクセス許可の違いを整理。数億ページという登録規模と、自社への引用・訪問・売上を分け、公開ページ一つから現状を確認する方法と、今後の発表で見る条件を紹介します。
AIクローラーが新しいページを見つける手掛かりに、Cloudflareのネットワーク情報を使う共同試験の初期結果が公表されました。 OpenAIが知らなかったページの発見を増やし、不要な取得を減らす試みです。サイトごとの訪問や売上への効果は、これから調べる段階です。[1]
詳しい説明書を公開しても、ChatGPTがそのページを見つけているかは、公開した側からすぐには分かりません。AIクローラーとは、AIの検索などに使う情報を集めるため、Webページを巡回する仕組みです。
今回の発表を読むときは、「ページを見つける」「内容を取得する」「回答の出典になる」「人が訪問する」を分けると、自社に関係する変化が分かります。以下は2026年10月16日時点の公式発表に基づく解説です。試験の報告と、既存の管理機能、サイト運営者向けの点検案を区別して読み進められます。
AIクローラーの発見を改善する、CloudflareとOpenAIの共同試験
今回のニュースは、7月に始めた研究試験について、10月15日に初期結果を報告したことです。 CloudflareはWebサイトの配信や通信の保護を支える会社で、OpenAIはChatGPTを提供する会社です。両社は、Cloudflareのネットワークで得られる手掛かりが、ChatGPT向けの情報発見に役立つかを調べています。[1]
読む際の中心は、新しい申込サービスの名称ではなく、公開された情報にたどり着く方法です。説明書や専門的な記事のように、内容が役立っても発見されているとは確認できないページに関係します。
まず、発表の時点、試験の対象、報告された数字をそろえて見ます。ここが曖昧なままだと、研究の進展を「今日から自社も使える機能」や「集客が増えた実績」として受け取ってしまいます。

7月の試験開始と10月15日の結果報告を分ける
共同試験の開始は2026年7月、今回の初期結果の公表は10月15日です。10月15日にすべてのサイトへ新機能が開放された、という発表ではありません。公式記事も、これまでに分かったことと、次に試すことを分けて説明しています。[1]
時点を整理すると、社内でこのニュースを共有する際の表現も変わります。「新機能が使えるようになったので設定する」ではなく、「ページ発見の試験で結果が報告されたので、対象と今後の提供条件を見る」という扱いです。
| 時点 | 発表から確認できる内容 |
|---|---|
| 2026年7月 | CloudflareとOpenAIが研究試験を開始 |
| 2026年10月15日 | ページの発見などに関する初期結果を公表 |
| 次の段階 | ページ選定、変更情報、発見後の成果をさらに検証 |
この表の最後の行には、確定した開始日を置けません。次段階の方針と提供日を混ぜずに読む必要があります。
試験開始の記事を以前読んでいた場合も、今回の新しさは結果の報告にあります。過去の予告と今回の観測を一つの出来事にまとめず、どの資料で何が追加されたかを追うと、続報でも判断を更新しやすくなります。
対象はCloudflareネットワークの約1%の参加群
結果は、Cloudflareのネットワーク全体の約1%に当たる参加群を使った試験の報告です。世界中のサイトの1%、日本のサイトの1%、あるいは各サイトのページの1%を調べたという意味ではありません。割合の対象は、公式記事が示した範囲にとどめて読む必要があります。[1]
ここで分かるのは、試験に一定の参加範囲があったことです。参加サイトの正確な数、業種や国別の内訳、無作為に選ばれたかどうかは、今回の発表だけでは確認できません。
例えば、自社が日本語の説明書を公開しているなら、知りたいのは同じ種類のページも対象だったかです。ネットワーク全体に対する割合だけでは、その問いへの答えになりません。この点は、試験の価値を否定する理由ではなく、自社への当てはめに必要な情報の違いです。
社内の資料に数字を移す場合は、「約1%」だけを大きく抜き出さず、「Cloudflareネットワークの参加群」と一緒に残すと誤読を防げます。残りの約99%が利用できないと決まった、と逆向きに読み替えることも避けます。
対象が限定された研究結果として受け取り、自社の参加可否は別に確認する。この読み方なら、試験全体の進展と、自社が今行える操作を混同せずに済みます。
新たに登録された数億ページと、自社の流入を分ける
OpenAIが以前把握していなかった数億のWebページを発見し、検索の登録先へ加えられたと報告されています。検索インデックスとは、検索に使うページの情報を登録しておく仕組みです。この数字はページの発見・登録の規模であり、訪問者数や購入件数ではありません。[1]
また、「新しいページ」は、すべてが試験期間中に新規公開されたという意味とも限りません。発表での比較対象は、OpenAIがそれまで知っていたかどうかです。以前から公開されていた説明書も、新たに発見される側に入り得ると読めます。
数字を事業計画へ使うときは、単位を変えないことが大切です。発見されたページが増えても、そのうち何ページが特定の回答で引用され、何人が訪問したかは、別の記録がなければ求められません。
| 知りたいこと | 必要になる情報 |
|---|---|
| 発見の広がり | これまで未知だったページの数 |
| 自社への紹介 | 回答に付いた自社ページのリンク |
| 自社への流入 | そのリンクなどを経由した訪問の記録 |
自社の報告では、この三つを別の欄にします。数億という試験全体の規模から、自社のアクセス増加率を計算することはできません。発見の改善を出発点に、その先で何が起きたかを確かめる順番です。
Cloudflareの情報が、ChatGPT検索のページ発見に使われる流れ
Cloudflareがページを見つける手掛かりを渡し、OpenAIがページの関連性や有用性を独立して評価します。 CloudflareがChatGPT検索の掲載順位を決める、という役割分担ではありません。情報を発見する段階と、その情報をどう検索に使うかという判断が分かれています。[1]
サイト運営者にとっては、自社のページに何が書いてあるかだけでなく、そのページの存在が見つかるかを考えるニュースです。ただし、発見経路が増えることを、あらゆるページが採用される保証としては読めません。
以下では説明書のページを例に、URLを知ることから、人が訪問することまでを順に見ます。これは流れを理解するための説明であり、公開されていないOpenAI内部の処理順や評価式を示すものではありません。

ネットワーク上の情報から、見つかっていないURLを探す
Cloudflareのネットワーク上の情報は、OpenAIの検索クローラーが有用なページを発見するための手掛かりに使われます。公式記事は、機種別の説明書や店舗の営業時間など、特定の問いに答えるページを例に挙げています。他サイトからのリンクが少なくても、役立つ情報を持つページがあるという説明です。[1]
URLは、そのページの場所を示すアドレスです。説明用に、ある機種の設置方法を掲載したページを考えると、会社のトップページを知っているだけでは、必要な説明の場所まで把握したとはいえません。
この場面で発見の手掛かりが役立つ理由は、情報の価値と、場所を見つけられているかが別だからです。詳しい説明が公開済みでも、対象ページを知らなければ、その内容を確かめるところまで進めません。
一方、今回の発表には、個々のページへ渡す情報の完全な項目一覧や、サイト担当者が入力する送信フォームは示されていません。想像した項目を新しい必須設定として追加する必要はありません。
自社で整理できるのは、発見してもらいたい公開ページがどれか、そのページが何の問いに答えているかです。説明書なら機種名と説明の対象が合っているかを見ます。発見の仕組みを知ることが、公開内容を具体的に見直す入口になります。
検索への登録と順位の判断はOpenAIが行う
検索でページをどう評価し、順位付けするかはOpenAIが独立して判断します。Cloudflareの情報を使ってページを見つけることと、検索で有用だと評価することを、一つの判断にまとめないのが今回の役割分担です。[1]
例えば、説明書のURLが見つかったとしても、質問が別の機種に関するものなら、その説明書が答えに合うとは限りません。この例からも、場所を知るための情報と、質問への適合を考える情報には違いがあると分かります。
ここから「Cloudflareを使うだけで順位が上がる」という導入理由を作ることはできません。発表が述べているのは共同試験の役割であり、サイトごとの順位改善を保証する商品条件ではないためです。
サービスを検討する社内資料では、確認した事実を「発見用の情報提供」と書き、期待することを「自社の必要なページが発見されるか」と分けておくと整理できます。期待を書いたことを、効果が測定されたことに置き換えないようにします。
評価の細かな基準や重みも、今回の発表からは分かりません。未知の評価式に合わせて文章を変えるより、説明の対象、適用条件、内容の正しさを明らかにしておく方が、読者へ何を伝えるページかを確かめられます。これは編集上の考え方であり、順位上昇の実証結果ではありません。
発見・取得・回答の引用・訪問を順に読み分ける
ページの発見はURLを知ること、取得はその内容を取りに行くことです。回答の引用は回答に出典として示されることで、訪問は人がサイトを開くことです。今回の報告を読むための整理として、これらを別の出来事に分けます。[1]
| 段階 | 説明書の例で確かめたいこと |
|---|---|
| 発見 | 対象機種の説明書のURLが見つかったか |
| 取得 | そのURLから説明の内容を受け取れたか |
| 引用 | 回答の出典にそのページが使われたか |
| 訪問 | 人が説明書のページへ進んだか |
この表は、前の段階が確認できれば次も成功したと判定する表ではありません。アクセス記録に取得の要求が残っていても、回答のどこで使われたかまでは、その記録だけでは分かりません。
反対に、回答内のリンクを一度確認できても、以後のすべての質問で同じページが使われると決めることはできません。観測した質問と日時を残すことで、後の結果と比べる対象が明確になります。
担当者間の報告でも、「AIに出た」という一言を、どの段階の確認なのかに置き換えると作業が決まります。取得の問題なら通信を見る必要があり、訪問後の問題なら読者の行動を見る必要があります。今回のニュースは、その入口にある発見の改善を理解する材料です。
AIクローラーが無駄に取得するURLを、三つの例で理解する
公式記事は、存在しないページ、一律にトップへ転送されるURL、同じ内容のコピーを、不要な取得につながる例として挙げています。 URLが多いことや、要求が多いことだけでは、役立つページが多いとは判断できません。これらの傾向を見分け、取得前に無駄を減らすことが試験の狙いです。[1]
ここでいう要求は、クローラーなどがページの内容を送ってほしいとサイトに求める通信です。人が関心を持って読んだ回数とは違います。自動の通信を、そのまま人気や顧客の需要と数えないところから考えます。
三つの例は、原因も確認するものも異なります。存在するか、目的の内容へ進めるか、別の情報があるかを分けると、同じ「アクセスが多い」という表示の中身を読み取りやすくなります。

存在しないファイルへの要求を、人気ページと取り違えない
存在しないファイルにも、自動の仕組みから要求が繰り返し送られることがあります。Cloudflareは、それによって実在しないページが興味深い対象のように見えてしまう例を示しています。要求回数だけを見れば、内容の有無を取り違える余地があるということです。[1]
説明用に、説明書のつづりを間違えたURLへ通信が集まる場面を考えます。要求があったという記録と、その場所に正しい説明書があるという確認は別です。数が多いから読者に必要な内容だと結論を出すと、存在しない対象に価値を見いだしてしまいます。
運営上の点検案としては、要求数の多いURLを見つけたときに、まず想定した内容が存在するかを確かめます。該当ページを開き、必要なら管理担当者に応答の記録を確認してもらいます。これは試験の内部手順を再現するものではありません。
存在しないことが分かっても、直ちにそのURL用の記事を作る必要はありません。要求を送っている主体と、どこからそのURLが生じたかが不明なら、人の需要があるとはまだいえないためです。
残す記録は、URL、要求の期間、返された結果、実在する内容の有無です。こうして要求とページを対応付ければ、「よく要求されるが情報を渡せていない対象」と「実際に内容があるページ」を分けられます。
どのURLもトップページへ転送するサイトで起きること
ほとんどどのアドレスを要求してもトップページへ転送するサイトでは、別々のURLを取りに行っても同じ入口へ戻されます。公式記事は、これを不要な取得を生む例として挙げています。転送先が開けることと、求めていたページに到達することは別です。[1]
説明書の例なら、対象機種の使い方を探しているのに、毎回会社のトップページが返る状態です。会社名やサービス紹介が読めても、その機種の設置手順を確認したことにはなりません。
この違いを見るには、最初に要求したURLと、最後に表示されたURLを一組で確認します。画面が表示されたという結果だけを残すと、途中で別のページへ移動したことが記録から抜けます。
ただし、転送がすべて不要という意味ではありません。今回の発表が問題の例としているのは、ほぼどのアドレスも同じトップへ送るような傾向です。サイト移転に伴う適切な転送まで、この記事から一律に無効と判断することはできません。
点検では、該当する説明が転送先にあるかを読み、意図と違うときに元URLと転送先を管理担当者へ渡します。単に転送をなくすのではなく、どの情報へ到達させたいかを先に示すことが、今回の例から得られる実務上の視点です。
同じ内容のコピーを、新しい情報として数えない
別のURLでも内容が同じコピーなら、新しい情報を見つけたとは限りません。Cloudflareは、このようなURLも取得の無駄を考える例に含めています。ページのアドレスの数と、内容の種類を分けて読む必要があります。[1]
説明用に、同じ機種の同じ説明書が、異なるURLで表示される場面を考えます。URLが二つあるだけでは、二種類の疑問へ答えられるようになったとはいえません。何が書かれているかを比べて初めて、追加の情報があるかが分かります。
点検するなら、ページ名だけでなく、対象機種、手順、条件、更新内容を並べます。似て見えても対象が異なる説明を、短いタイトルの一致だけでコピーと判断しないようにします。
| 比べるもの | 見分けたい違い |
|---|---|
| 対象 | 同じ機種や同じサービスの説明か |
| 本文 | 新しい手順や条件が含まれるか |
| 更新内容 | 日付以外に実際の変更があるか |
この確認表は、サイト内の情報を読むための提案です。OpenAIの重複判定の具体的な基準や、採用されるURLの選び方を示すものではありません。
コピーを見つけても、参照先や利用目的を調べず削除する段階へは進みません。まず新しい情報の有無を確かめることで、URLを増やすこと自体をページ発見の成果と取り違えずに済みます。
更新を知らせる情報で、AIクローラーの再取得を効率化する
変更の情報を使い、もう一度取得する価値があるページを見分けようとしているのが、鮮度に関する試験です。 すべてのページを頻繁に取り直す方法では、変わっていない内容も繰り返し送ることになります。新しい情報に追いつきながら、不要な通信を減らす両立が狙いです。[1]
ここでいう再取得とは、以前読んだページの内容をもう一度取りに行くことです。説明書の内容が修正された場合と、何も変更されていない場合では、再び取得して得られる情報が異なります。
この話では、アクセスが減ったかという総数だけで判断しないことが大切です。変化のないページへの再訪と、新たに見つかったページの確認を分けると、負荷と発見を同じ物差しで評価せずに済みます。

内容が変わっていないページの再取得を減らす狙い
内容の変わっていないページを繰り返しダウンロードすると、サイトには通信の負荷がかかります。今回の試験では、変更を知らせる情報から、再び訪れる価値があるかを判断する方向が示されています。取得回数を一律に少なくすることだけが目的ではありません。[1]
説明書を例にすると、内容が昨日と同じなら、取り直しても新しい手順は増えません。一方、重要な注意事項を直したなら、以前の内容のまま扱われてほしくないと考えられます。この二つを分けるために、変化を示す情報が関係します。
サイト側の記録でも、再取得の回数だけでは、負荷が必要なものだったかを説明しきれません。変更したページと時刻が残っていれば、アクセスの増減を見たときに、更新後の確認なのかを調べる材料になります。
ただし、その記録を作ることが本試験へのデータ送信になるわけではありません。自社で更新と通信を照合するための点検案であり、Cloudflareが求める専用の入力形式ではないことを分けておきます。
最適な再取得の間隔も、発表から一律には決められません。毎時、毎日と独自に数値を設定して公式の推奨とせず、試験が扱っている問いを「変わったページに必要な取得を向けられるか」と捉えると、狙いが明確になります。
新しいページが見つかると、取得が増える場合もある
新しいページが見つかると、その内容の評価や検索への登録のため、最初はクロールが増える場合があります。公式記事も、この増加と不要な取得の削減のバランスに言及しています。試験によってアクセスが必ず減る、と期待するのは正確ではありません。[1]
説明用に、今まで発見されていなかった複数の説明書が見つかる場面を考えます。その内容を調べる通信が生じるなら、既存ページへの無駄な再訪が減っていても、全体の要求数だけでは増加が見える可能性があります。
そこで、運営上は二つの問いを分けます。以前から読まれている同じページへの要求がどう変わったかと、これまで要求のなかった公開ページに通信が来たかです。これなら、総数だけで試験の成功や失敗を決めずに済みます。
| 観測する変化 | 追加で確かめること |
|---|---|
| 同じページへの要求が増えた | 本文の更新や応答の変化があったか |
| 別のページにも要求が来た | どの公開内容が新たに対象になったか |
| 全体の要求が減った | 必要なページへの取得も止まっていないか |
表は、変化を見つけた後の点検案です。自社が試験に参加していると確認できていなければ、アクセスの変化を共同試験の効果に帰属させることはできません。観測したことと原因の判断を分けて残します。
更新の速さと負荷削減率は、追加報告を待つ
更新から何分で反映されるか、負荷が何%減るかという確定値は、今回の発表では示されていません。次の段階で、より速く信頼性の高い変更情報を試す方針が説明されています。改善の方向は分かっても、運用上の期限や保証値はまだ置けません。[1]
この違いは、説明書を更新した直後の対応を考えると分かりやすくなります。サイトの本文を修正した時刻と、AIが新しい内容を回答に使った時刻は、同じ記録ではありません。前者を記録しても、それだけで後者を確認したことにはなりません。
また、再取得を確認できた場合にも、回答への反映は別に観測する必要があります。「更新情報が速い」「ページを取り直すのが速い」「回答が変わるのが速い」は、何を測った速さかを確かめて読む言葉です。
続報で数値が示されたら、開始点と終了点、対象ページ、比較期間を一緒に確認します。平均なのか、特定の条件の例なのかが違えば、社内で期待する反映時間の置き方も変わります。
現時点では、確定した時間を顧客向けに約束する根拠として使わず、更新日と実際の表示を分けて追うのが現実的です。変更情報の研究が進んでいることを理解しながら、未公表の速度を補わない読み方になります。
ページ発見への協力と、AIのアクセス許可を分ける
ページについての情報が渡っても、それ自体がアクセスの許可を与えるわけではありません。 共同試験の説明は、サイト所有者が選ぶ利用方針を前提にしています。ページを発見するための手掛かりと、内容を読める権限は、別に扱う必要があります。[1]
公開された説明書を見つけてもらいたい場合も、会員だけに見せたい情報まで同じ扱いにする必要はありません。どのページを誰に公開するかという判断を、発見の話だけで置き換えないことが大切です。
以下では、特に間違えやすい権限、学習用の本文、既存の許可・遮断機能を分けます。AIに関する機能という共通点だけで、研究への参加、本文の提供、アクセス制御を一つの操作として捉えないための整理です。

ページの情報が渡っても、閲覧権限は自動で増えない
ページの存在を知らせる情報は、そのページを読む権限そのものではありません。公式記事は、ページに関するシグナルがアクセス許可を与えないと明記しています。シグナルとは、ここではページを見つけたり状態を判断したりする手掛かりとなる情報です。[1]
説明用に、公開の説明書と会員向けの追加資料が別にあるサイトを考えます。追加資料のURLを知ることと、会員として本文を読むことは異なります。URLが知られたら認証が解除される、という仕組みとして本試験を理解するのは誤りです。
一方、この説明だけを理由に、あらゆる非公開情報が安全だと確認できたことにもなりません。自社が実際に何を配信しているか、閲覧制限がどこにかかっているかは、サイト側の別の確認対象です。
運営者がまず整理するなら、発見してもらいたい公開情報と、閲覧を制限する情報をページ単位で分けます。両方が同じページにある場合も、どの部分を公開する方針かが曖昧なまま、AI向けの許可を広げないようにします。
今回のニュースは、認証の実装方法を変更する手順ではありません。発見の改善を検討するときにも、公開範囲の判断はサイト所有者に残るという点を押さえると、集客の期待と閲覧権限を混同せずに話し合えます。
検索・発見用のメタデータと、モデル学習の本文を区別する
今回の研究は、検索や発見のためにWebに関するメタデータを使うものと説明されています。モデル学習のためにページ本文を共有する研究とは区別されています。メタデータは、本文そのものとは別に、そのページについて伝える情報を指します。[1]
例えば、ページの場所を見つけるための情報と、説明書の文章全体は同じものではありません。今回の発表を「説明書の本文を学習用にまとめて渡す仕組み」と要約すると、研究の説明を変えてしまいます。
ただし、公開されているのは本研究の用途の説明です。これを、他のすべてのアクセスや別サービスの処理でも本文が学習に使われないという包括的な保証に広げることはできません。
社内で確認するときは、何の仕組みの話かをそろえます。本試験で扱う情報の用途なのか、自社が特定のクローラーを許可する方針なのか、他の契約で提供する内容なのかを分ければ、異なる条件を一緒に議論せずに済みます。
検索向けと学習向けのクローラーの違いを先に知りたい場合は、AIクローラーの役割を整理した基礎記事で確認できます。今回の試験の説明から言える範囲は、検索・発見向けのメタデータ利用という用途までです。未公表の項目や処理を推測して足す必要はありません。
AI Crawl Controlは、既存の許可・遮断を確認する場所
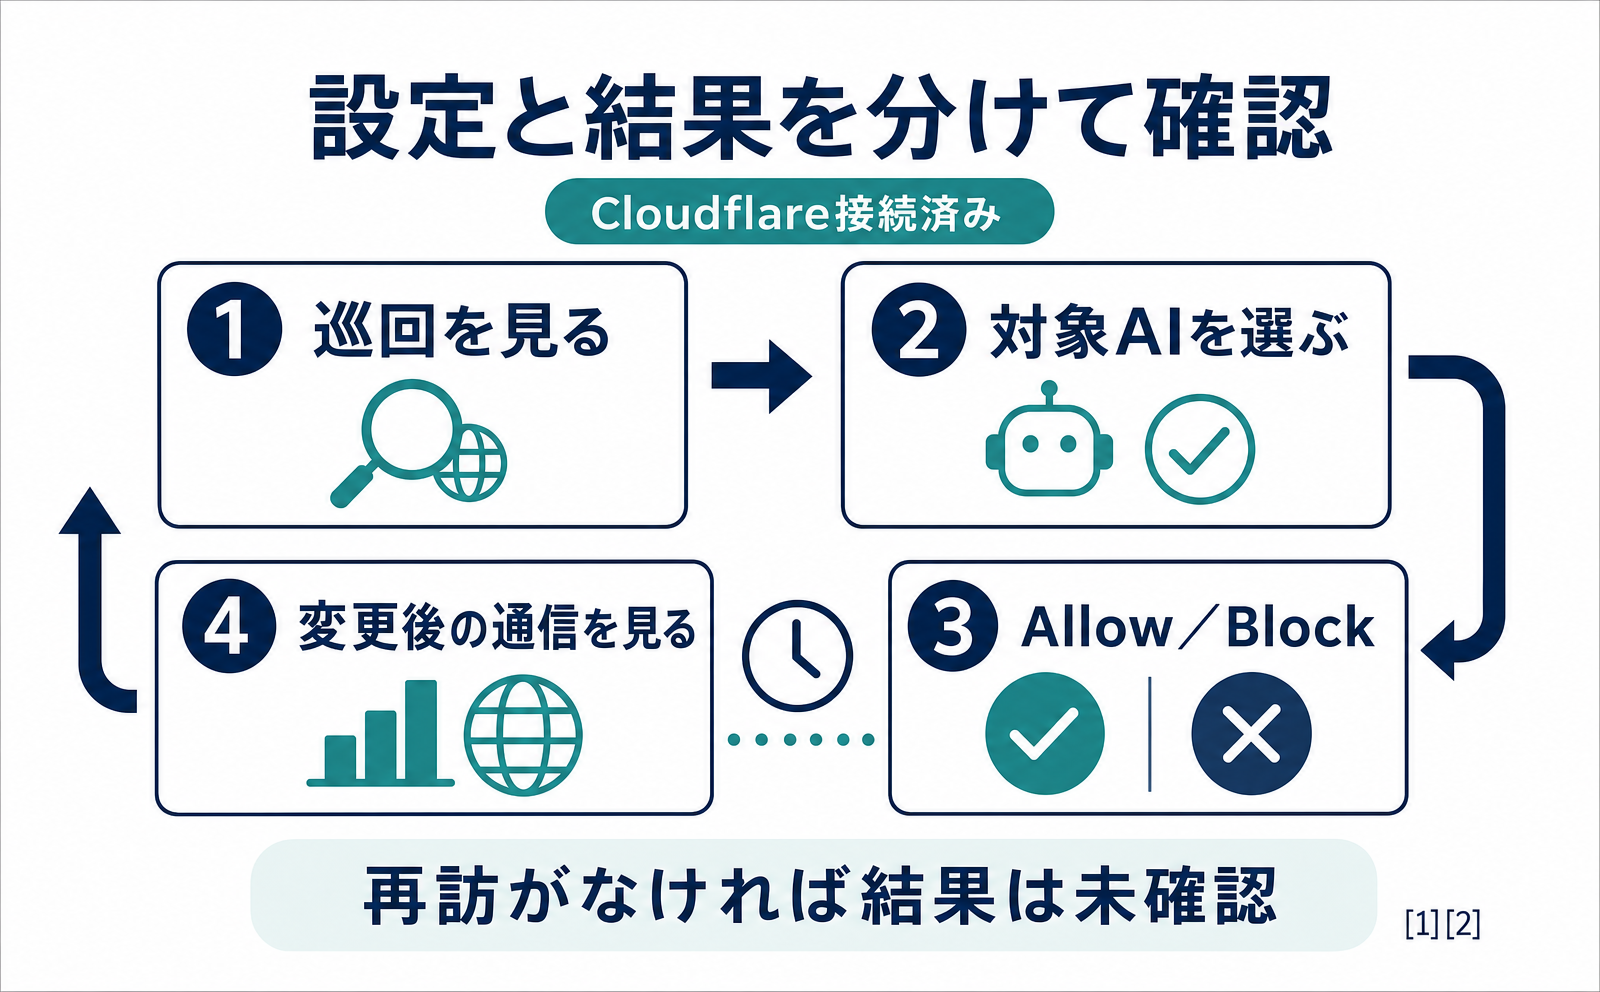
AI Crawl Controlは、CloudflareでAIクローラーのアクセスを確認・管理する機能です。公式資料では、クローラーごとのAllowで許可、Blockで遮断を選べると説明されています。共同試験に参加するための申込ボタンとして紹介されているわけではありません。[2]
設定を確認する場合は、Cloudflareの管理画面で対象のアカウントとドメインを選び、AI Crawl Controlを開きます。ここでは自社の管理権限が必要です。どのドメインの、どのクローラーの設定を見ているかを先にそろえます。[2]
資料では冒頭にSecurity、一覧説明にはCrawlersという表記があるため、本文の一語だけを頼りに別の設定を操作しないようにします。見る対象はクローラーの名前、運営元、現在のAllow/Blockです。確認するだけなら、選択値を変える必要はありません。
Allow/Blockを変更するかは、自社の公開方針とそのクローラーの用途に沿って判断します。今回のニュースを見たという理由だけで、すべてを許可する操作へ進まないようにします。
詳しい操作はCloudflareでAIの巡回を確認・制限するガイドにまとめています。本稿は公式文書を参照した説明で、自社環境の設定変更や共同試験への参加を実施した記録ではありません。
有害なページの検出と、事業成果はまだ検証が続く
今回の報告には、有害なページを見分ける試験と、発見後の事業成果をこれから調べる方針も含まれています。 発見したページの数だけで研究全体を理解せず、どのページを除くか、発見された後に何が起きるかも別の問いとして読む必要があります。[1]
有害なページの検出は、利用者が危険な内容へ進むのを防ぐための話です。訪問や売上の測定は、情報を公開したサイトにどのような結果が生じるかを調べる話です。目的が異なるため、片方の進展をもう片方の成果の証拠にはできません。
自社で実際の数字を見るときにも、要求数と参照元を別に残すと整理できます。以下では、今回の公式報告で確認できた範囲と、既存の分析画面で見られることを分けて示します。

侵害された一ページを、ドメイン全体と分けて扱う試み
正規のサイトに不正なページが一つ入り込んだ場合、そのページを見分けて扱う情報も試験されています。公式記事が挙げるのは、攻撃者が設置した偽のログイン画面です。ページ単位で問題を捉えることで、サイト全体を同じ扱いにしない方向を示しています。[1]
ドメインは、サイトのまとまりを示す名前です。その中に多くのページがあるとき、一部の問題と、残りのページの内容を分けて考える必要があります。説明書が正しくても、同じサイト内の別ページに問題がある、という場面を思い浮かべると分かります。
ただし、初期結果は、すべての有害ページを発見できるという保証ではありません。検出の精度や見逃しの割合が今回の発表で確定したわけではなく、個々のサイトが検査済みだと判断する資料にもできません。
| 公式報告で示されたこと | 別に必要となる確認 |
|---|---|
| 問題のあるページを示す情報を試験 | 検出精度と対象条件 |
| 一ページを区別して扱う考え方 | 自社に問題のページがあるか |
この表から、サイト管理者が安全確認を省略できるとは読めません。研究の方向を理解することと、自社で起きた問題を調べることを分け、発見経路の改善だけでサイト全体の安全が確認されたと説明しないようにします。
発見後の引用・訪問・売上は、今後の測定対象
発見が改善された後に、実際の事業成果へどうつながるかは、引き続き調べる方針です。今回の公式報告から、自社への引用や訪問、売上が一定割合で増えると結論付けることはできません。数億ページという数字を、その後の成果へ変換しない読み方が必要です。[1]
運営者の立場では、発見されたことに加えて、そのページを必要としている人へ届いたかを知りたくなります。説明書なら、対象機種の疑問を持つ人が内容を読めたかが関係します。購入を目的とするページなら、訪問後の購入はさらに別の確認対象です。
そのため、成果の報告を受け取る際は、「何が一件として数えられたか」を確認します。出典リンクが付いた回答、ページを開いた訪問、申し込みの完了は、数える出来事が違います。
また、増加が観測されても、本試験だけが原因とは限りません。自社で別のページを公開したり、内容を更新したりした場合は、その変更も記録しておくと、同じ期間に何があったかを振り返れます。
これは成果を否定するための整理ではなく、何が改善したかを正しく説明するためのものです。今後の報告では、対象サイト、測定した行動、期間、比較相手が示されるかを確認します。発見の進展に期待しながら、事業の判断は対応する成果の記録に基づけます。
自社の要求数と参照元を、同じ期間で分けて記録する
AI Crawl Controlでは、クローラーの要求数や応答の内訳、参照元などを確認できます。参照元は、どこからサイトへ来たかを示す情報です。公式資料では参照元の分析に有料プラン条件があるため、表示されない項目をゼロと扱わないようにします。[3]
点検案として、対象のアカウントとドメインを選び、AI Crawl ControlのMetricsで期間をそろえます。必要に応じてクローラー、運営元、ホスト名、パスで絞り込みます。パスは、URLのうちページの場所を示す部分です。[3]
| 別々に残す項目 | 読み取る内容 |
|---|---|
| All requests | 遮断やエラーを含む要求の総数 |
| Allowed requests | 200〜299の成功応答が返った要求 |
| Status code distribution | 成功、転送、エラーなどの内訳 |
| 参照元の情報 | AIサービスからの訪問元。利用条件を確認 |
要求が多くても、成功して内容を取得できた要求ばかりとは限りません。参照元から分かる訪問とも別の列にしておくと、通信が増えたのか、人の訪問が増えたのかを読み分けられます。
公式資料にあるDownload CSVを使う場合は、適用した期間と絞り込みも記録します。[3] この手順は公式文書に基づく点検案で、実アカウントで本試験の効果を計測した結果ではありません。
この発表を踏まえたAI検索対策の考え方
今の運営に生かすなら、発見させたい公開ページ、取得の状況、発見後の成果を分けて把握するところから始められます。 共同試験への参加を確認できていなくても、自社の公開内容と現在の通信を整理する作業は考えられます。試験に参加済みだと仮定する必要はありません。
今回の発表は、ページの内容を整えるだけでなく、存在が見つかり、必要なときに取得されることにも課題があると示しています。一方、参加条件や事業成果まで確定した導入案内にはなっていません。[1]
最後に、自社の公開ページを一つ選ぶ点検案と、続報で判断を変える項目をまとめます。何でも一度に設定し直すのではなく、現状と未確認のことを具体的に分けておくための使い方です。

発見させたい公開ページを、一つ選んで現状を残す
最初の点検対象には、読者の具体的な疑問に答えている公開ページを一つ選びます。説明書なら、どの機種の何を説明するページかを明確にします。以下は自社の現状を整理するための提案で、共同試験への登録手順ではありません。
- 公開済みの対象ページを開き、実際のURLを控えます。
- 何の問いに答えるページかを一文で書き、本文にその答えがあるか読みます。
- 最後に内容を変更した日を、自社の更新記録で確認します。
- アクセス記録を使える場合は、そのURLへの要求と応答を、期間を決めて確認します。
公式の分析機能では、対象パスや期間を絞り、要求や応答の内訳を見ることができます。[3] 使っていない機能の数値を埋める必要はなく、記録を取得できない場合はその項目を未確認にします。
結果が「ページは開くが目的の説明がない」なら、先に内容を点検します。「内容はあるが取得の記録がない」なら、未発見と断定せず、調べた期間と対象の範囲を残します。記録がない理由を、今回の発表だけで特定することはできません。
この作業の到達点は、一つのURLについて、公開内容と確認できた通信を説明できることです。AI回答への掲載を達成したという扱いにせず、次に確認する対象を絞る資料として使います。
Cloudflare未利用サイトや日本での参加条件は未確認
今回の発表だけでは、一般参加の方法、料金、日本のサイトの対象範囲、提供開始時期を確定できません。Cloudflareを使っていないサイトがどう参加できるかも、この記事で案内できる状態ではありません。未確認の申込先や契約条件を補うことは避けます。[1]
この状態は、将来も参加できないと決まったことを意味しません。発表が扱うのは研究試験の初期結果で、一般向けの利用条件を網羅した案内とは役割が違うということです。
導入検討の資料を作るなら、「研究の対象」「自社が利用できるか」「必要な費用」を別の欄にします。最初の欄に情報があっても、残りの欄が埋まるとは限りません。約1%という参加範囲から、自社の資格や料金を逆算することもできません。
Cloudflareの既存利用者であっても、AI Crawl Controlが表示されることを共同試験への参加確認に置き換えないようにします。クローラー管理の機能と、今回の研究の参加条件は別に確認する対象です。[1][2]
社内から参加可否を聞かれた場合は、公式発表のURLと確認日を添え、どの条件が未公表なのかを答えます。「すぐ使える」「日本は対象外」とどちらかへ決めつけず、条件が出た時点で判断を更新できる記録にしておきます。
次の発表で確認する、対象範囲と発見後の成果
続報では、利用できる対象が広がるのかと、発見後の成果がどこまで測られたかを別々に確認します。公式記事は、ページ選定の改善、変更情報の検証、発見後に起きることの測定を次の段階に挙げています。[1]
| 続報で見る項目 | 自社の判断につながる問い |
|---|---|
| 対象と参加条件 | 自社のドメインや運用形態で利用できるか |
| 変更情報の検証 | 何を起点に、どの反映までの速さを測ったか |
| 発見後の成果 | 引用、訪問、購入のどれを数えたか |
| 比較条件 | どの期間、どの対象と比べた結果か |
数値が増えたという報告だけでなく、その数字を自社でどう確かめられるかも見ます。対象や期間が分からない場合は、導入効果の見積もりへそのまま使わず、追加で必要な情報として残します。
日々の許可・遮断を見直したい場合は、先に紹介したAI Crawl Controlの設定ガイドへ進めます。検索向けと学習向けの違いを知りたい場合は、AIクローラーの基礎記事が読み分けの入口になります。
今回分かったのは、ページ発見の手掛かりを増やす共同試験が進んでいることです。自社では公開したい情報の場所を明確にし、取得、引用、訪問のどこまで確認できたかを残すと、次の発表を実際の運営判断につなげられます。
よくある質問
- Q. Cloudflareを使えばChatGPT検索に必ず出ますか?
- 今回の発表は共同試験の初期結果で、掲載や順位を保証するものではありません。OpenAIがページの関連性や有用性を独立して評価します。[1]
- Q. 本文をAI学習へ提供する試験ですか?
- 公式記事は、検索・発見向けのWebメタデータを使う研究で、モデル学習のためのページ本文共有とは区別しています。他の処理すべてに適用される保証ではありません。[1]
- Q. クローラーのアクセスは必ず減りますか?
- 必ず減るとは説明されていません。新たに見つかったページの評価や登録によって、初期のクロールが増える場合もあります。[1]
- Q. 日本のサイトも参加できますか?
- 今回の発表からは、日本の対象範囲、一般参加の方法、料金や提供開始時期を確定できません。AI Crawl Controlの利用と試験への参加は別に確認する必要があります。[1][2]
出典・参考データ
- [1] Cloudflare and OpenAI: making AI discovery better for everyone (Cloudflare / OpenAI) — 取得 2026-10-16
- [2] Manage AI crawlers (Cloudflare) — 取得 2026-10-16
- [3] Analyze AI traffic (Cloudflare) — 取得 2026-10-16
この記事を書いた人
水島 翔吾株式会社kairos 代表取締役 / AgentSignal 開発者
AI クローラー・AI 流入計測と AIO 診断ツール AgentSignal を開発。実測データを元に AI 検索時代の計測と対策を書いています。
関連記事
計測・サイト改善
AIクローラーとは?GPTBotを止めてもChatGPT検索に出る理由
AIクローラーは、AI企業が公開ページを読むためのプログラムです。GPTBotとOAI-SearchBotの違い、Google-Extendedの扱い、robots.txtで断っても訪問が続く理由、目的別の設定の決め方を説明します。
公開
計測・サイト改善
CloudflareでAIの巡回を確認・制限する方法
CloudflareのAI Crawl Controlで、自社サイトを巡回するAIを確認し、個別に許可・拒否する手順を解説。無料プランの検出方法と分析期間、Security/Crawlersの表記差、Allowでもアクセスに失敗する場合の確認点を紹介します。
公開
計測・サイト改善
Content Signalsとは?検索利用とAI学習を分けて伝える方法
検索には使ってほしいが、AI学習への使用は断りたい。Content Signalsの3用途とrobots.txtへの記載例を解説します。未記載の意味、取得制限との違い、Cloudflareの管理機能、設定後の確認ポイントを整理します。
公開